Un parc de 2 500 applications à faire tourner sur Kubernetes, et une première question sur la table: un, trois ou six clusters? Un cluster pour tout le parc. Un cluster par département, il y en a trois. Un cluster par domaine métier, il y en a six.
La question a l’air technique, et elle l’est en partie: un cluster a des limites, un control plane, un etcd à protéger. Mais la réponse retenue, huit clusters permanents répartis en quatre groupes de domaines, plus un bac à sable à durée limitée, ne sort pas d’un calcul de capacité. Elle sort d’une autre question: qui décide de quoi, et pour quelles applications.
Ce qu’un cluster doit garantir
Un cluster Kubernetes de production a plusieurs masters, qui portent le control plane, et plusieurs nœuds de travail, qui portent les applications. L’état du cluster vit dans etcd, qui fonctionne par quorum: une majorité de membres doit s’accorder pour écrire. D’où le nombre impair de masters. Trois membres tolèrent la perte d’un seul; quatre aussi, puisqu’il en faut alors trois pour former la majorité. Le quatrième coûte sans rien ajouter.
Le projet Kubernetes publie aussi les limites des configurations qu’il prévoit: 110 pods par nœud, 5 000 nœuds, 150 000 pods et 300 000 conteneurs au total. Ces limites fixent un plafond. Elles ne disent pas où couper. Pour cela, il faut comparer.
Un seul cluster ou plusieurs: la grille
À charge égale, pour le même parc applicatif, la comparaison tient dans cette grille.
| Critère | Un seul cluster | Plusieurs clusters |
|---|---|---|
| Coût | bas | élevé |
| Administration du cluster | facile | difficile |
| Administration des applications | difficile | facile |
| Résilience | faible | haute |
| Isolation | réduite | complète |
| Efficience | optimisée | dégradée |
| Failles de sécurité | propagées | locales |
Le cluster unique gagne sur ce qui se compte en euros et en machines: un seul control plane à exploiter, un seul ensemble de nœuds partagé, peu de capacité perdue. Il perd sur tout le reste. L’isolation entre applications repose sur des namespaces, des quotas et des network policies: une isolation logique, qu’une erreur de configuration suffit à traverser. Une faille, un composant du cluster qui tombe, une montée de version ratée touchent tout le parc à la fois. Et l’administration des applications devient difficile précisément parce que celle du cluster est simple: chaque application vit avec les contraintes de toutes les autres.
Plusieurs clusters inversent la grille. Chacun garde sa marge de capacité, l’efficience baisse et le coût monte; il y a plus de control planes à exploiter et à mettre à jour. En échange, une panne ou une faille reste locale, et chaque cluster peut évoluer au rythme des applications qu’il porte.
D’où une position nette: au-delà d’une prise en main dans le cadre d’un POC, confier la production à un seul cluster Kubernetes est fortement déconseillé. Le cluster unique est le bon outil pour apprendre. C’est un mauvais pari pour 2 500 applications.
Trois façons de découper
Une fois admis qu’il en faut plusieurs, reste à choisir la ligne de coupe. La littérature en propose trois.
- Par environnement. Un nombre fixe d’environnements pour tout le parc; chaque type d’environnement a sa taille, ses règles de sécurité et son nombre d’utilisateurs habilités.
- Par produit. Mieux adapté à une architecture microservices où chaque produit regroupe plusieurs dizaines de composants et d’instances; le nombre d’environnements varie d’un produit à l’autre.
- Par équipe. Pour des équipes matures et autonomes, qui gèrent leur propre parc applicatif et dimensionnent elles-mêmes leurs clusters et leurs environnements.
Il existe aussi une approche hybride, où les composants d’une même application se répartissent sur plusieurs clusters. Elle est rarement utilisée, parce que très complexe, et ce n’est pas par elle qu’on commence.
Un, trois ou six
Pour les 2 500 applications, les trois options sur la table suivaient l’organisation existante: le parc entier, les trois départements, les six domaines métier.
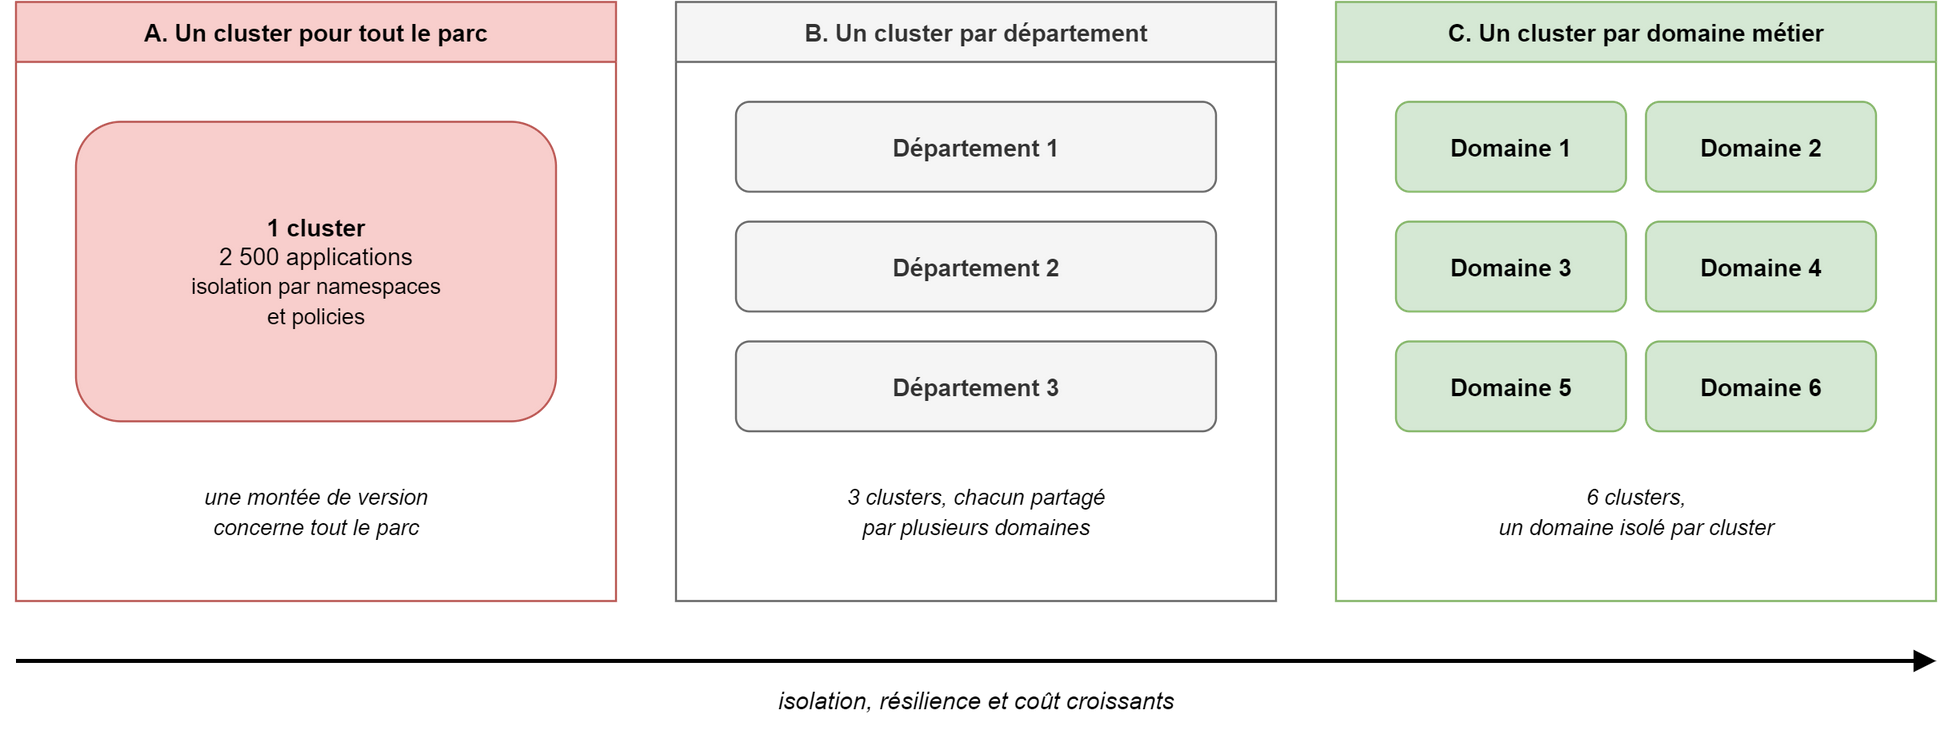
Deux questions ont pesé plus que la capacité.
La première est la montée de version des nœuds. Kubernetes publie trois versions mineures par an, ne maintient que les trois plus récentes, chacune pendant environ un an, et ne permet pas de sauter une version mineure lors d’une mise à jour. Avec la version 1.28, sortie en août, un cluster suit ce rythme ou sort du support. Or une montée de version n’est pas toujours neutre. Une évolution peut être incompatible avec l’existant; l’ajout d’un outil ou d’une nouvelle policy s’applique à tout ce qui tourne. PodSecurityPolicy en est un exemple: son retrait en 1.25 obligeait à migrer les règles de sécurité des pods avant de monter de version. Dans un cluster unique, chacune de ces décisions engage 2 500 applications en même temps, et leurs propriétaires avec.
La seconde est la campagne de performance. Chaque département a une équipe dédiée à la performance de ses applications. Une campagne de charge sur un cluster partagé mesure aussi le bruit des voisins, et leur impose le sien.
Ces deux questions écartent le cluster unique. Entre trois et six, elles penchent vers six: un cluster par département isole mieux qu’un cluster pour tous, mais chacun mélange encore plusieurs domaines métier, et une montée de version s’y négocie toujours entre eux.
Ce qui a été retenu
Nos recommandations ont pris le domaine métier isolé comme unité, avec deux ajustements.
Le premier: deux paires de domaines ont été regroupées. Les six domaines donnent quatre groupes.
Le second: chaque groupe possède deux clusters permanents, pas un. Un cluster hors production pour le développement, le staging et les branches de fonctionnalité; un cluster de production pour la préproduction et la production. Quatre groupes de deux clusters: huit clusters permanents à gérer.
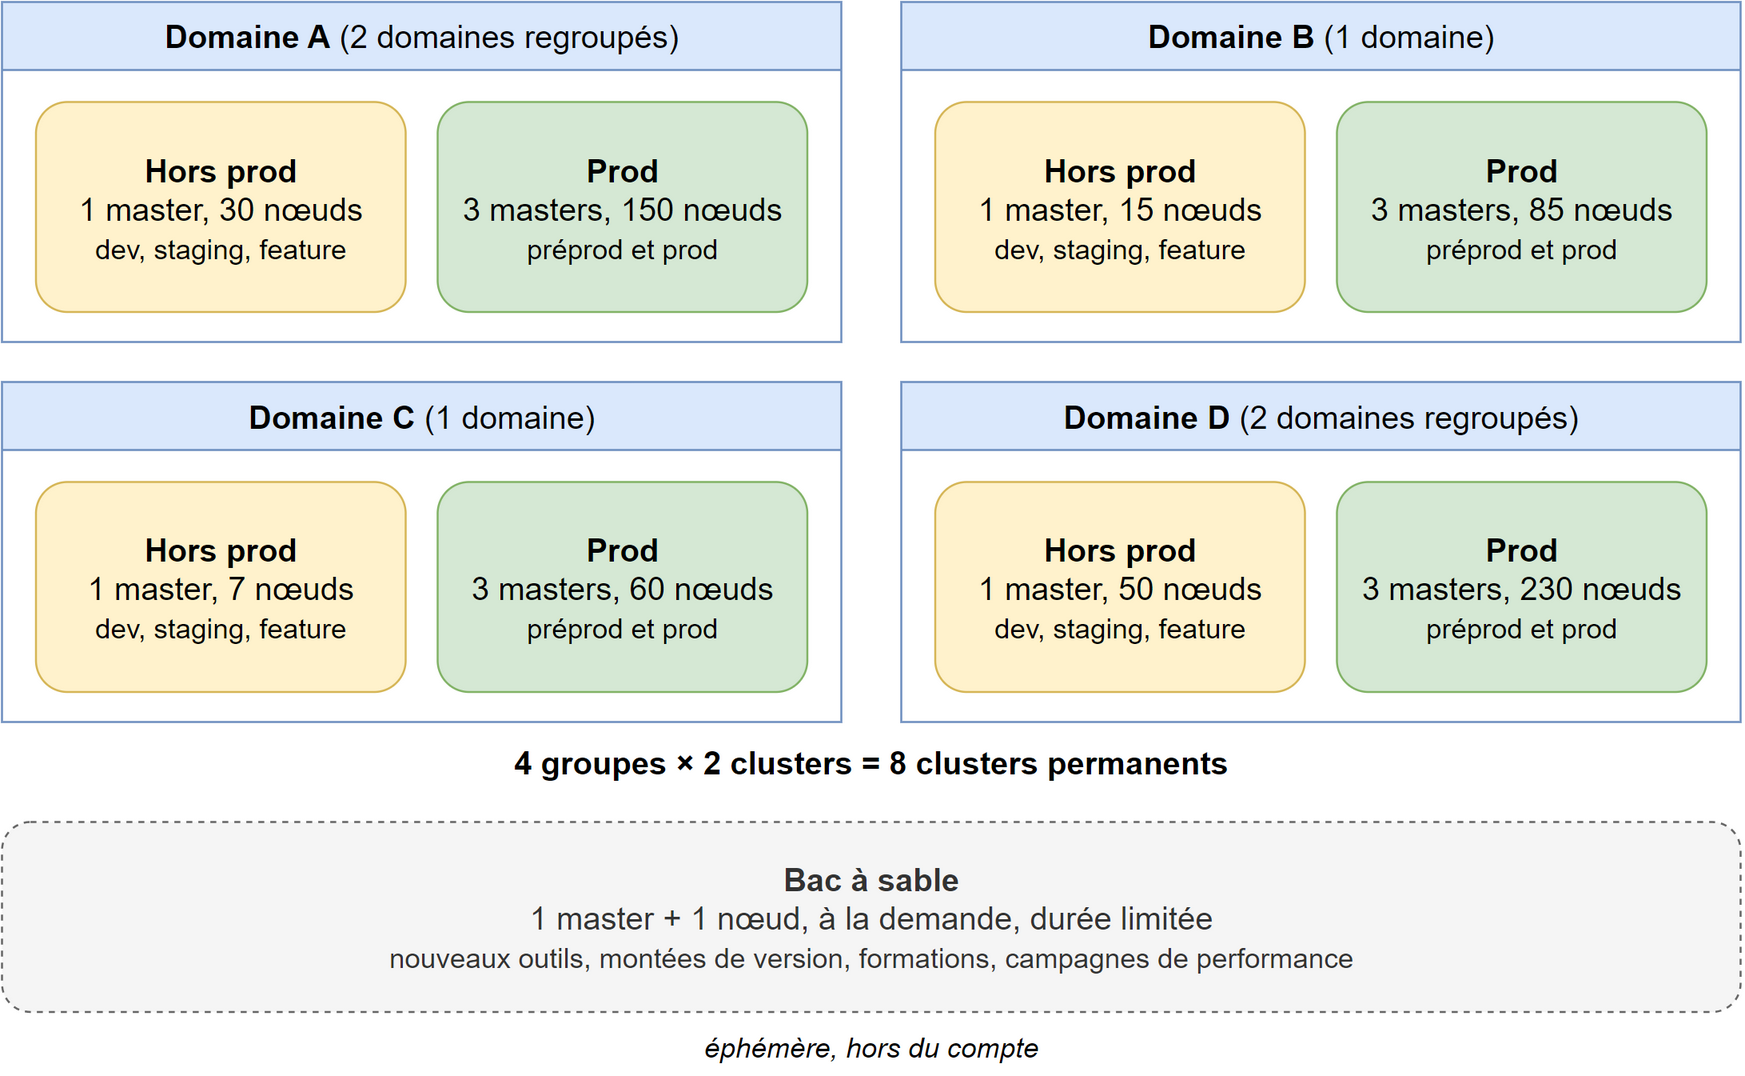
L’état final, avec le nombre de nœuds déployés:
| Groupe | Hors production | Production |
|---|---|---|
| Domaine A (deux domaines) | 1 master, 30 nœuds | 3 masters, 150 nœuds |
| Domaine B | 1 master, 15 nœuds | 3 masters, 85 nœuds |
| Domaine C | 1 master, 7 nœuds | 3 masters, 60 nœuds |
| Domaine D (deux domaines) | 1 master, 50 nœuds | 3 masters, 230 nœuds |
Soit 627 nœuds de travail, dont 525 en production, et 16 masters.
Quelques détails comptent autant que le découpage.
- Un master hors production, trois en production. Hors production, perdre le control plane quelque temps est acceptable; en production, le quorum d’etcd impose trois masters.
- Des nœuds dimensionnés différemment. La taille des nœuds n’est pas la même en production et hors production, le disque d’etcd non plus: hors production, des disques à faibles I/O suffisent.
- Huit est un socle, pas un plafond. Des clusters de production supplémentaires, Prod-1, Prod-2, accueillent les applications qui ne peuvent pas migrer.
- Reconstruire plutôt que réparer. Des jobs et des scripts reconstruisent un cluster qui tombe, pour ne pas pénaliser tous ceux qui en dépendent; ils font partie du plan de continuité informatique et du plan de continuité d’activité.
Un bac à sable qui expire
La première de nos recommandations ne figure pas dans le compte des huit: un cluster composé d’un master et d’un nœud, créé à la demande et pour un temps limité. Il sert à tester de nouveaux outils, à qualifier les évolutions, à former les équipes et à mener les campagnes de performance. Il peut compter plus de masters ou de nœuds quand le cas le justifie, une campagne de charge par exemple.
C’est lui qui répond aux deux questions du départ. Une montée de version se qualifie dans le bac à sable avant de toucher un cluster permanent; une campagne de performance s’y déroule sans voisins. Il coûte peu parce qu’il ne dure pas, et la durée limitée est une règle, pas un détail: un bac à sable qui reste devient un neuvième cluster permanent, que personne n’a décidé de posséder.
La topologie dessine l’organisation
Les trois découpages de la littérature ne sont pas trois options techniques. Ce sont trois modèles de responsabilité. Découper par environnement suppose une équipe centrale qui possède les environnements de tout le parc. Découper par produit suppose des équipes produit qui portent leurs propres environnements. Découper par équipe suppose des équipes assez matures pour exploiter leurs clusters elles-mêmes.
Derrière «combien de clusters?», la vraie question est donc: qui peut décider seul d’une montée de version, d’une nouvelle policy, d’une fenêtre de maintenance? Un cluster partagé par plusieurs propriétaires transforme chaque changement en négociation; un cluster par propriétaire le transforme en décision. C’est ainsi que je lis le choix du domaine métier: il suit la ligne le long de laquelle l’organisation décide déjà.
Le regroupement de domaines montre l’autre côté de la balance. Chaque cluster de plus est un cluster à monter de version trois fois par an, à surveiller, à savoir reconstruire. La ligne de coupe suit la responsabilité, mais elle s’arrête là où l’équipe qui exploite la plateforme peut encore tenir le rythme.
Avant de compter les clusters
La question «un, trois ou six?» se règle rarement par un calcul de capacité. Elle se règle en dessinant d’abord qui possède quoi, puis en plaçant les frontières des clusters sur ces lignes, avec un endroit à part, et éphémère, pour essayer ce qui pourrait tout casser.