«Faites-vous du DevSecOps?» La réponse est presque toujours oui. On analyse les dépendances, SonarQube tourne, la sécurité est «dans le pipeline». Vient alors la question suivante: sur combien de projets, depuis quand, avec quel résultat? Et la réponse s’arrête.
La démarche DevSecOps est déclarée partout et mesurée presque nulle part. Une réponse déclarative ne dit rien. «Oui, on scanne» ne dit ni sur quels dépôts, ni ce que l’on fait des résultats, ni si le scan tourne encore après la dernière refonte du pipeline.
Pour mesurer, il faut deux instruments, parce qu’il y a deux questions. Un modèle de maturité dit ce que les équipes savent faire, preuves à l’appui. Un tableau de bord mensuel dit ce que cela change sur le parc applicatif, chiffres à l’appui.
Un modèle de maturité: OWASP DSOMM
Le DevSecOps Maturity Model de l’OWASP (DSOMM) décrit la sécurité d’une chaîne de livraison en cinq dimensions: build et déploiement, culture et organisation, implémentation, collecte d’informations, test et vérification. Elles se découpent en 19 sous-dimensions, de la gestion des correctifs à l’analyse statique de l’infrastructure, et regroupent un peu moins de deux cents activités, chacune rattachée à un niveau de 1 à 5. Dans la version des données que j’ai installée au printemps, celle de mai 2025, j’en compte 191.
Chaque activité est décrite de la même façon: le risque qu’elle couvre, la mesure attendue, sa difficulté de mise en œuvre (connaissances, temps, ressources), son utilité, ses correspondances avec OWASP SAMM et l’ISO 27001, et, pour deux activités sur trois, des outils ou pratiques pour la mettre en œuvre. Certaines dépendent d’autres activités. Le modèle ne dit pas «faites des tests de sécurité»: il dit lesquels, et à quel niveau.
Sa vue la plus lisible est la heatmap circulaire. Chaque tranche est une sous-dimension, chaque anneau un niveau, du centre vers le bord. Une case se colore quand les activités de ce niveau sont faites.
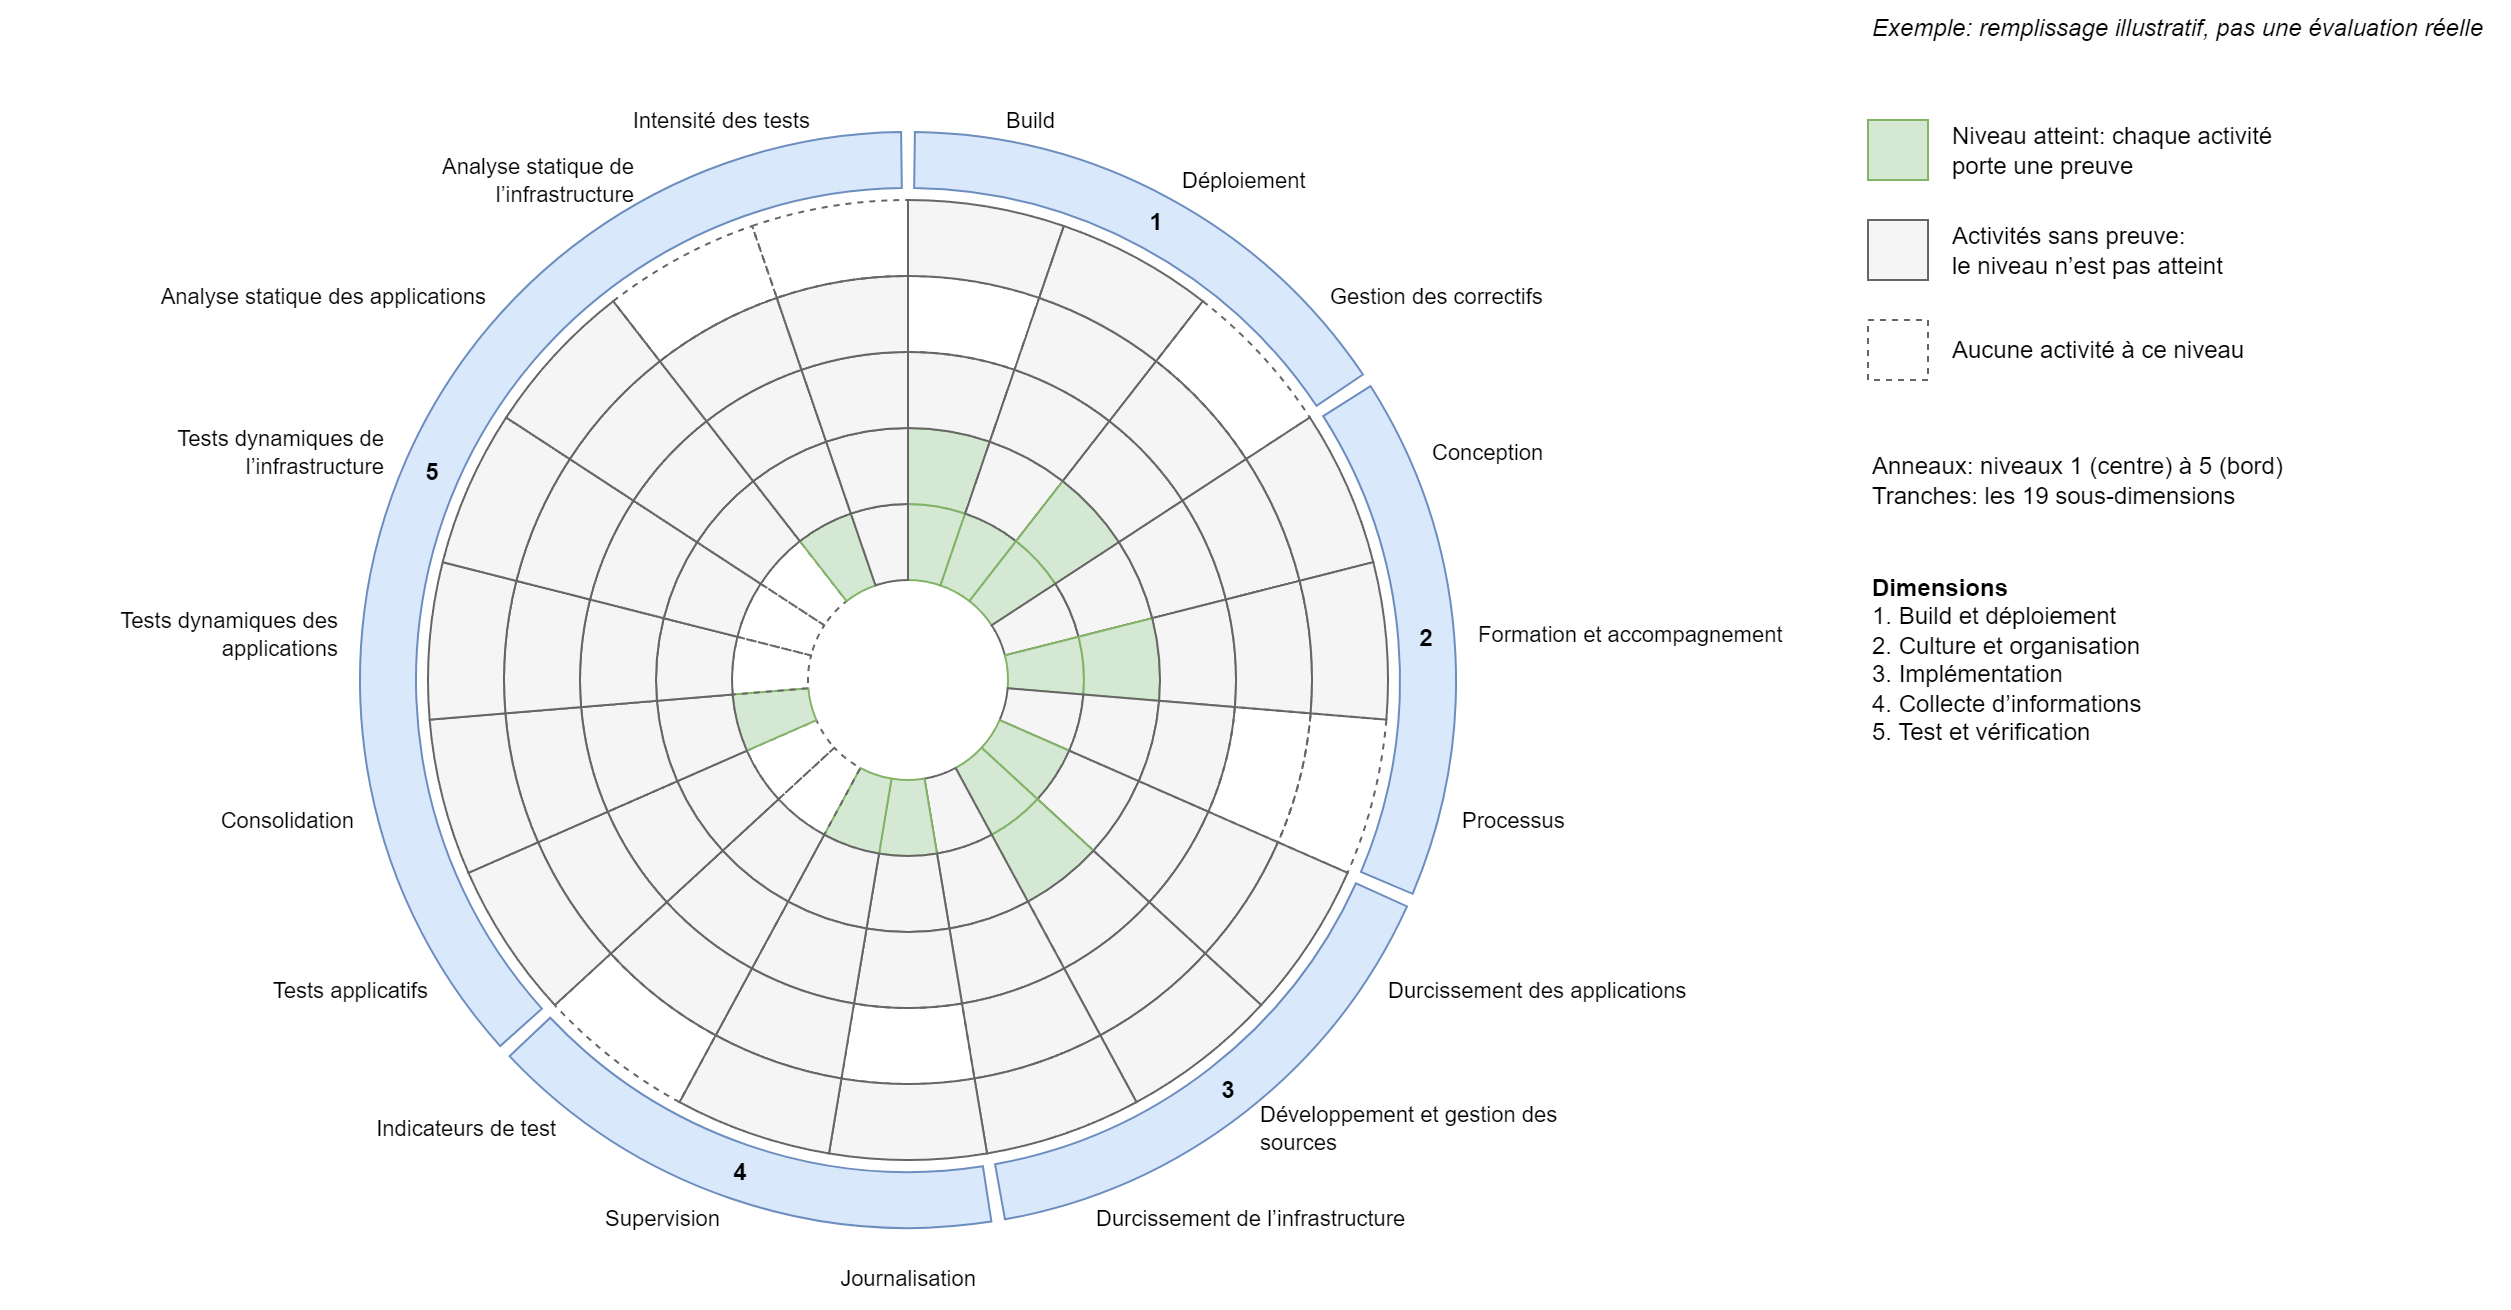
La répartition dit déjà quelque chose. Le durcissement de l’infrastructure compte 26 activités; viennent ensuite, avec 17, la formation et l’accompagnement, devant la supervision et l’analyse statique des applications. Certaines cases n’existent pas: les tests dynamiques et l’analyse statique des applications commencent au niveau 2.
Une activité ne compte qu’avec sa preuve
Remplir la heatmap est facile: on clique sur des cases. C’est précisément le problème. Une case cochée sans preuve est une réponse déclarative de plus, en couleur.
La règle est donc simple: une activité n’est faite que si une preuve y est
attachée. Le modèle le permet. Dans ses fichiers YAML, chaque activité porte,
pour chaque équipe, deux champs: teamsImplemented, vrai ou faux, et
teamsEvidence, un texte qui décrit la preuve.
teamsImplemented:
  Paiement: true
  Portail: false
  Facturation: true
teamsEvidence:
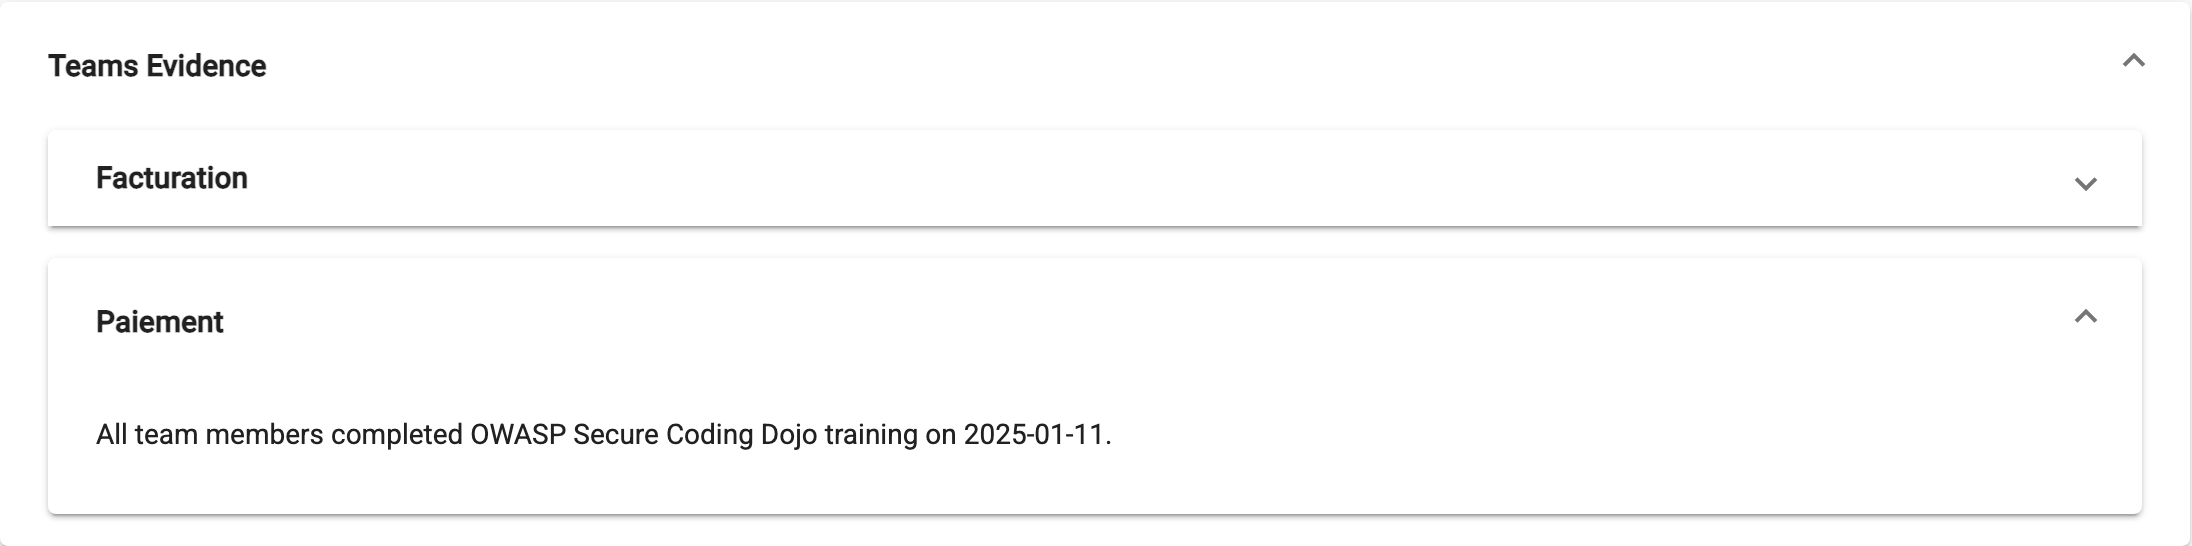
  Paiement: All team members completed OWASP Secure Coding Dojo training on 2025-01-11.
  Facturation: |
Dans cet exemple, adapté de la documentation, l’équipe Facturation déclare
l’activité faite sans preuve. C’est exactement ce qu’il faut éviter. On n’écrit
pas teamsImplemented à la main: on écrit la preuve, et on laisse le générateur
en déduire le reste.
Le générateur de données du projet le fait quand on le lance avec
IS_IMPLEMENTED_WHEN_EVIDENCE=true: pour chaque équipe dont la preuve n’est pas
vide, il passe teamsImplemented à vrai; pour une preuve vide, il affiche un
avertissement. Il vérifie aussi la cohérence du modèle (identifiants uniques,
niveaux renseignés, dépendances qui pointent vers des activités existantes) et
s’arrête s’il trouve une erreur.
Installer, collecter, valider, publier
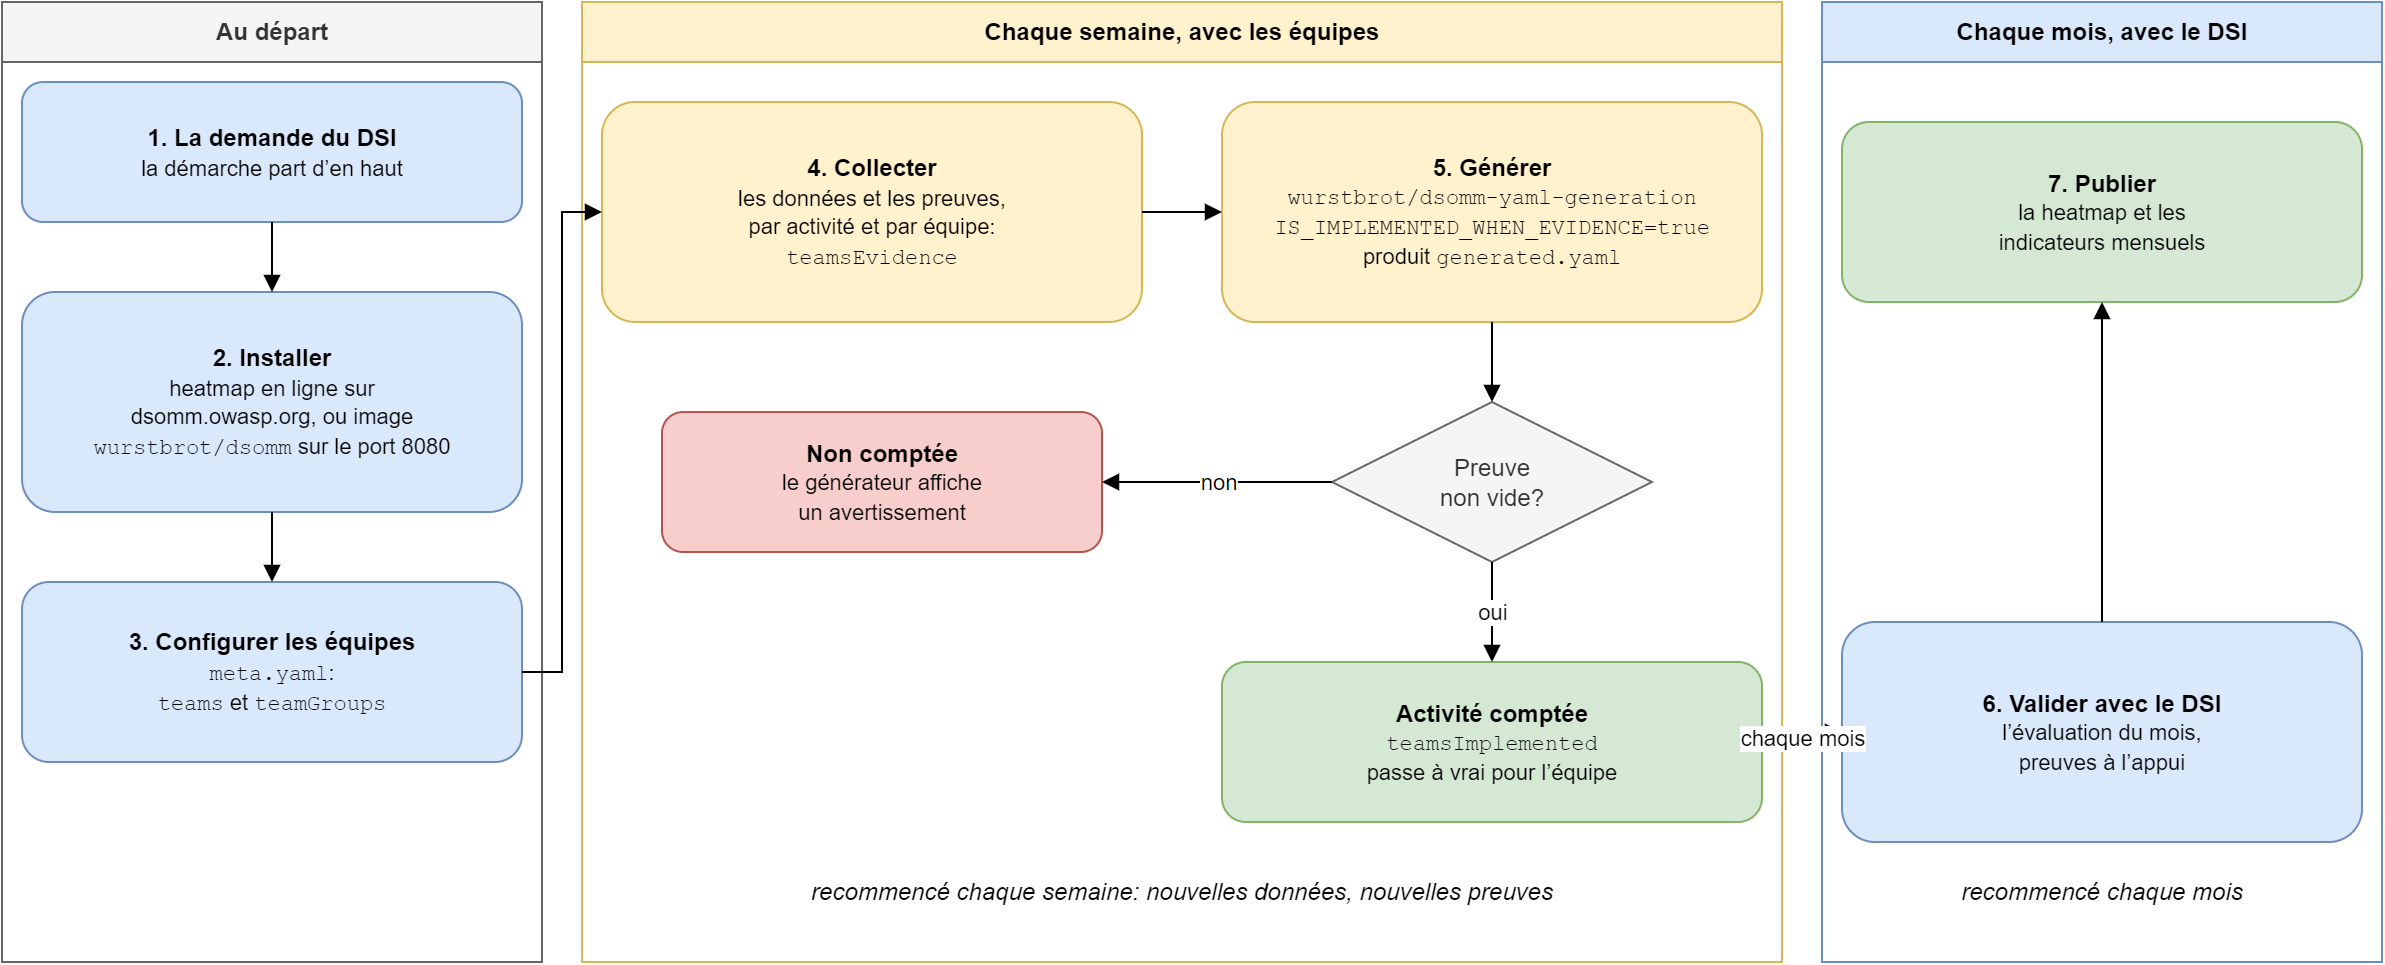
J’ai appliqué cette méthode à plusieurs reprises, chaque fois à la demande d’un DSI: elle ne part pas des équipes, elle part d’en haut. Ce qui suit en décrit une application. La méthode se joue en deux boucles: une collecte chaque semaine avec les équipes, une validation chaque mois avec le DSI.
-
La demande du DSI. La démarche part de là.
-
Installer. Deux voies, qui ne servent pas au même usage.
La version en ligne, sur
dsomm.owasp.org, ne demande rien. Le menu de gauche mène à la matrice (Matrix), à la heatmap circulaire (Overview), aux correspondances avec les autres référentiels (Mappings) et aux équipes (Teams), celles de l’exemple: Default, B et C. Sur Overview, on clique sur une case de la heatmap: une carte liste les activités de la case, et chaque activité, dépliée, porte une case à cocher par équipe. Ce qu’on coche reste dans le navigateur, rien n’est enregistré sur le site, et aucun champ ne permet d’y saisir une preuve. Pour garder le résultat, le bouton Download edited YAML file, en bas de la heatmap, télécharge ungenerated.yaml; Reset Implemented efface les coches du navigateur. Le site ne sait pas recharger ce fichier: il sert à découvrir le modèle, pas à suivre une évaluation dans la durée.Pour plusieurs équipes, je l’héberge moi-même: l’application existe en image Docker.
docker run -d -v $(pwd)/meta.yaml:/srv/assets/YAML/meta.yaml \
  -p 8080:8080 wurstbrot/dsomm
On ouvre
http://localhost:8080: c’est la même application, qui s’ouvre sur la matrice, mais avec nos équipes. La page Teams les liste avec leurs groupes. Sur Overview, les filtres par groupe et par équipe s’affichent à droite de la heatmap, et un clic sur une case ouvre en dessous la carte de ses activités. Tant qu’aucune preuve n’a été générée, aucune équipe n’est cochée.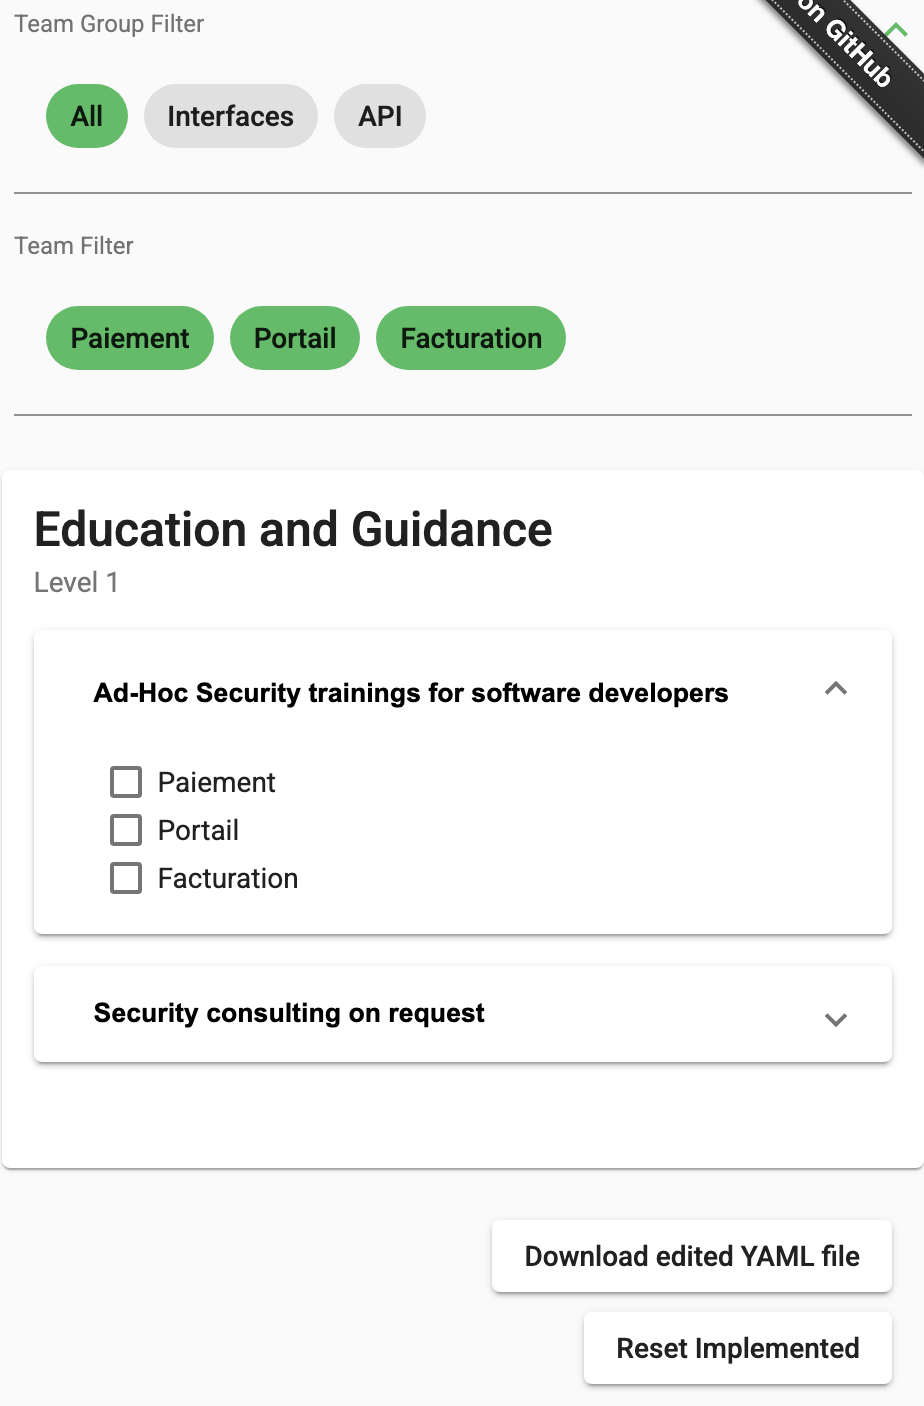
-
Configurer les équipes. Le fichier
meta.yamldéclare les équipes et leurs regroupements, que la heatmap propose ensuite en filtres. Une équipe peut appartenir à plusieurs groupes.teams: ['Paiement', 'Portail', 'Facturation'] teamGroups: Interfaces: ['Paiement', 'Portail'] API: ['Paiement', 'Facturation'] -
Collecter, chaque semaine, avec les équipes. On recueille les données et les preuves, activité par activité, et on les écrit dans les fichiers YAML du modèle. Ces fichiers vivent dans un dépôt git. Chaque équipe y propose ses preuves par une demande de fusion qui ne touche qu’une chose: la ligne à son nom sous
teamsEvidence, dans l’activité concernée. Une preuve dit quoi, quand, et où le vérifier: une date, un lien vers le rapport ou le ticket. La relecture refuse toute ligneteamsImplemented: écrite à la main, elle compte l’activité même sans preuve. -
Générer. Le générateur relit ces fichiers et produit
generated.yaml. On le lance depuis une copie du dépôt de données du modèle,DevSecOps-MaturityModel-data.docker run -e "IS_IMPLEMENTED_WHEN_EVIDENCE=true" \ -v $(pwd)/src/assets/YAML/default:/var/www/html/src/assets/YAML/default \ -v $(pwd)/meta.yaml:/var/www/html/src/assets/YAML/meta.yaml \ -v $(pwd)/generated:/var/www/html/src/assets/YAML/generated \ wurstbrot/dsomm-yaml-generationChaque volume a son rôle:
defaultcontient le modèle lui-même: un dossier par dimension, un fichier YAML par sous-dimension, dix-neuf en tout, etimplementations.yaml, le catalogue des outils et pratiques que citent les activités. C’est là qu’on a écrit les preuves à l’étape 4.meta.yamldéclare nos équipes. Sans lui, le générateur prend celui de l’image, l’exemple, et ne connaît que Default, B et C.generatedreçoit le résultat,generated.yaml: toutes les activités en un seul fichier, avecteamsImplementeddéduit des preuves. On ne le modifie pas à la main: on le régénère.
Le dépôt contient aussi un dossier
schemas, que le générateur ne lit pas. Ses schémas JSON servent à l’éditeur, vers lequel renvoie la première ligne de chaque fichier YAML: ils signalent un champ mal saisi pendant la collecte.Le générateur n’a pas d’interface, rien à cliquer: il écrit dans le terminal, une ligne par fichier lu et par activité. Sur l’exemple de l’équipe Facturation, la sortie dit ceci.
Reading src/assets/YAML/default/BuildAndDeployment/Build.yaml
…
Warning: '… -> Facturation' has no evidence set but should have
…
Storing to /var/www/html/src/assets/YAML/generated/generated.yaml
Dans
generated.yaml, l’activité porte alorsPaiement: true, etFacturation: false, commePortail, qui n’a rien déclaré. Chaque avertissement est une preuve à reprendre avec l’équipe avant la génération suivante.Une erreur, elle, bloque tout: le générateur les liste en
ERROR:et s’arrête surPlease fix the errors, sans écrire le fichier. -
Valider, chaque mois, avec le DSI. On valide l’évaluation du mois écoulé, preuves à l’appui. Une fois validée, on étiquette le dépôt du nom du mois,
2025-08pour août: l’étiquette fige les preuves que le DSI a vues, et la collecte de la semaine suivante ne la touche plus. -
Publier. On publie depuis l’étiquette du mois, jamais depuis la branche de collecte: on la récupère (
git checkout 2025-08), on relance le générateur de l’étape 5, puis l’application, avecmeta.yamletgenerated.yamlmontés dans le conteneur.docker run -d -v $(pwd)/meta.yaml:/srv/assets/YAML/meta.yaml \ -v $(pwd)/generated:/srv/assets/YAML/generated \ -p 8080:8080 wurstbrot/dsommSur
http://localhost:8080, la même carte coche désormais Paiement, et seulement Paiement. La preuve se lit sur la fiche de l’activité, qu’on ouvre en cliquant sur son nom, dans la carte ou dans la matrice, à la rubrique Teams Evidence. La heatmap publiée est celle que le DSI a validée, et elle accompagne les indicateurs mensuels.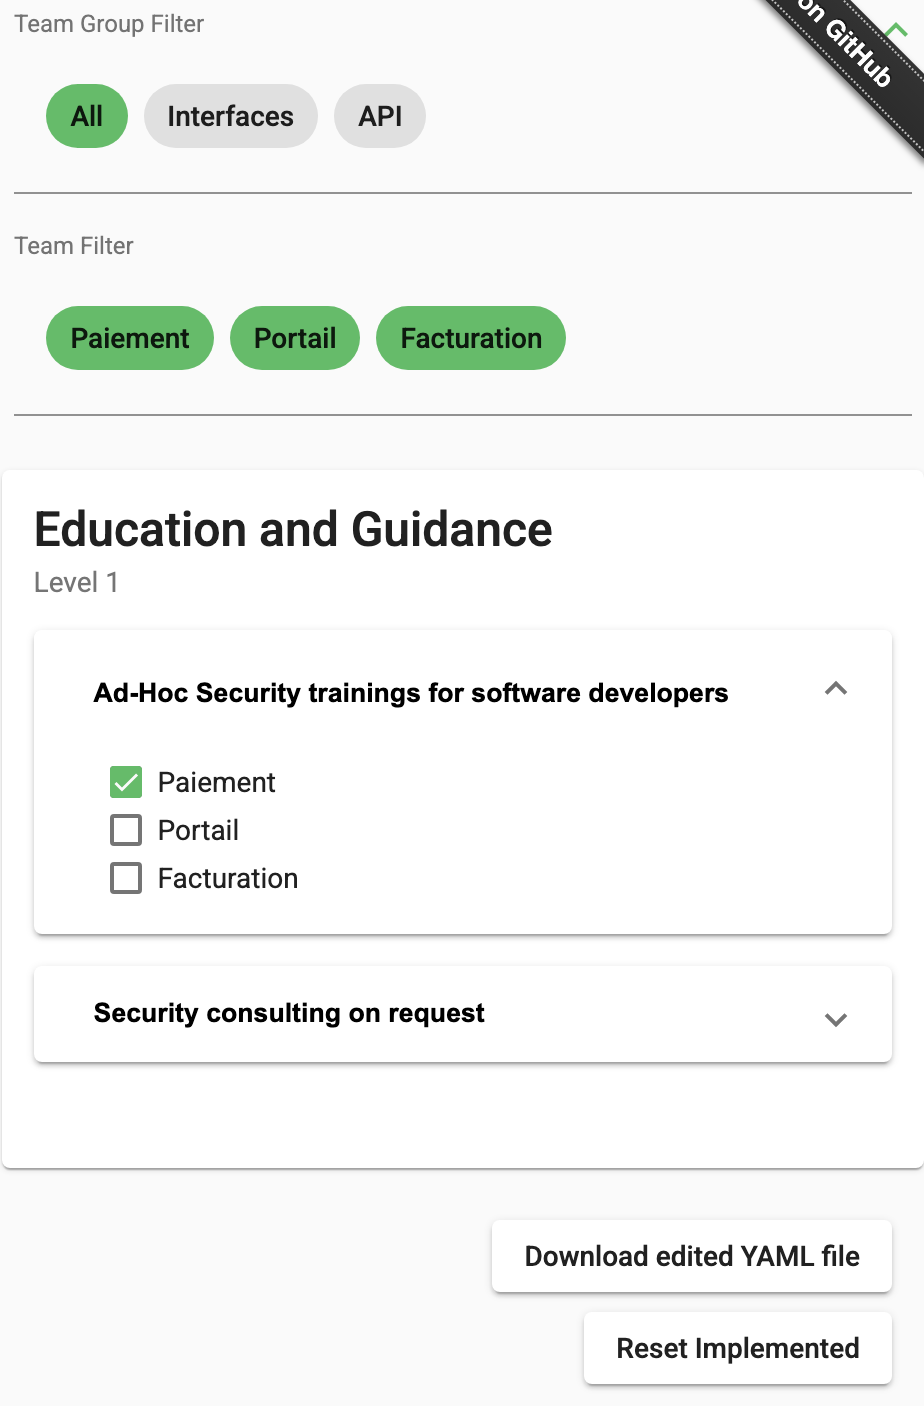
Un tableau de bord mensuel sur quatre axes
Le modèle de maturité dit ce que les équipes savent faire. Il ne dit pas si le parc est moins exposé ce mois-ci que le précédent. Le modèle prévoit d’ailleurs lui-même cette mesure: sa sous-dimension consacrée aux indicateurs demande de suivre le nombre de vulnérabilités par sévérité, le temps moyen de correction, le taux de correction par dépôt. C’est le rôle du tableau de bord mensuel.
Il tient sur quatre axes, trois indicateurs chacun, et chaque indicateur a une source et une cible. Sans source, un chiffre est une opinion; sans cible, c’est un décor. Voici le mois d’août des équipes avec lesquelles je travaille, et la tendance sur trois mois.
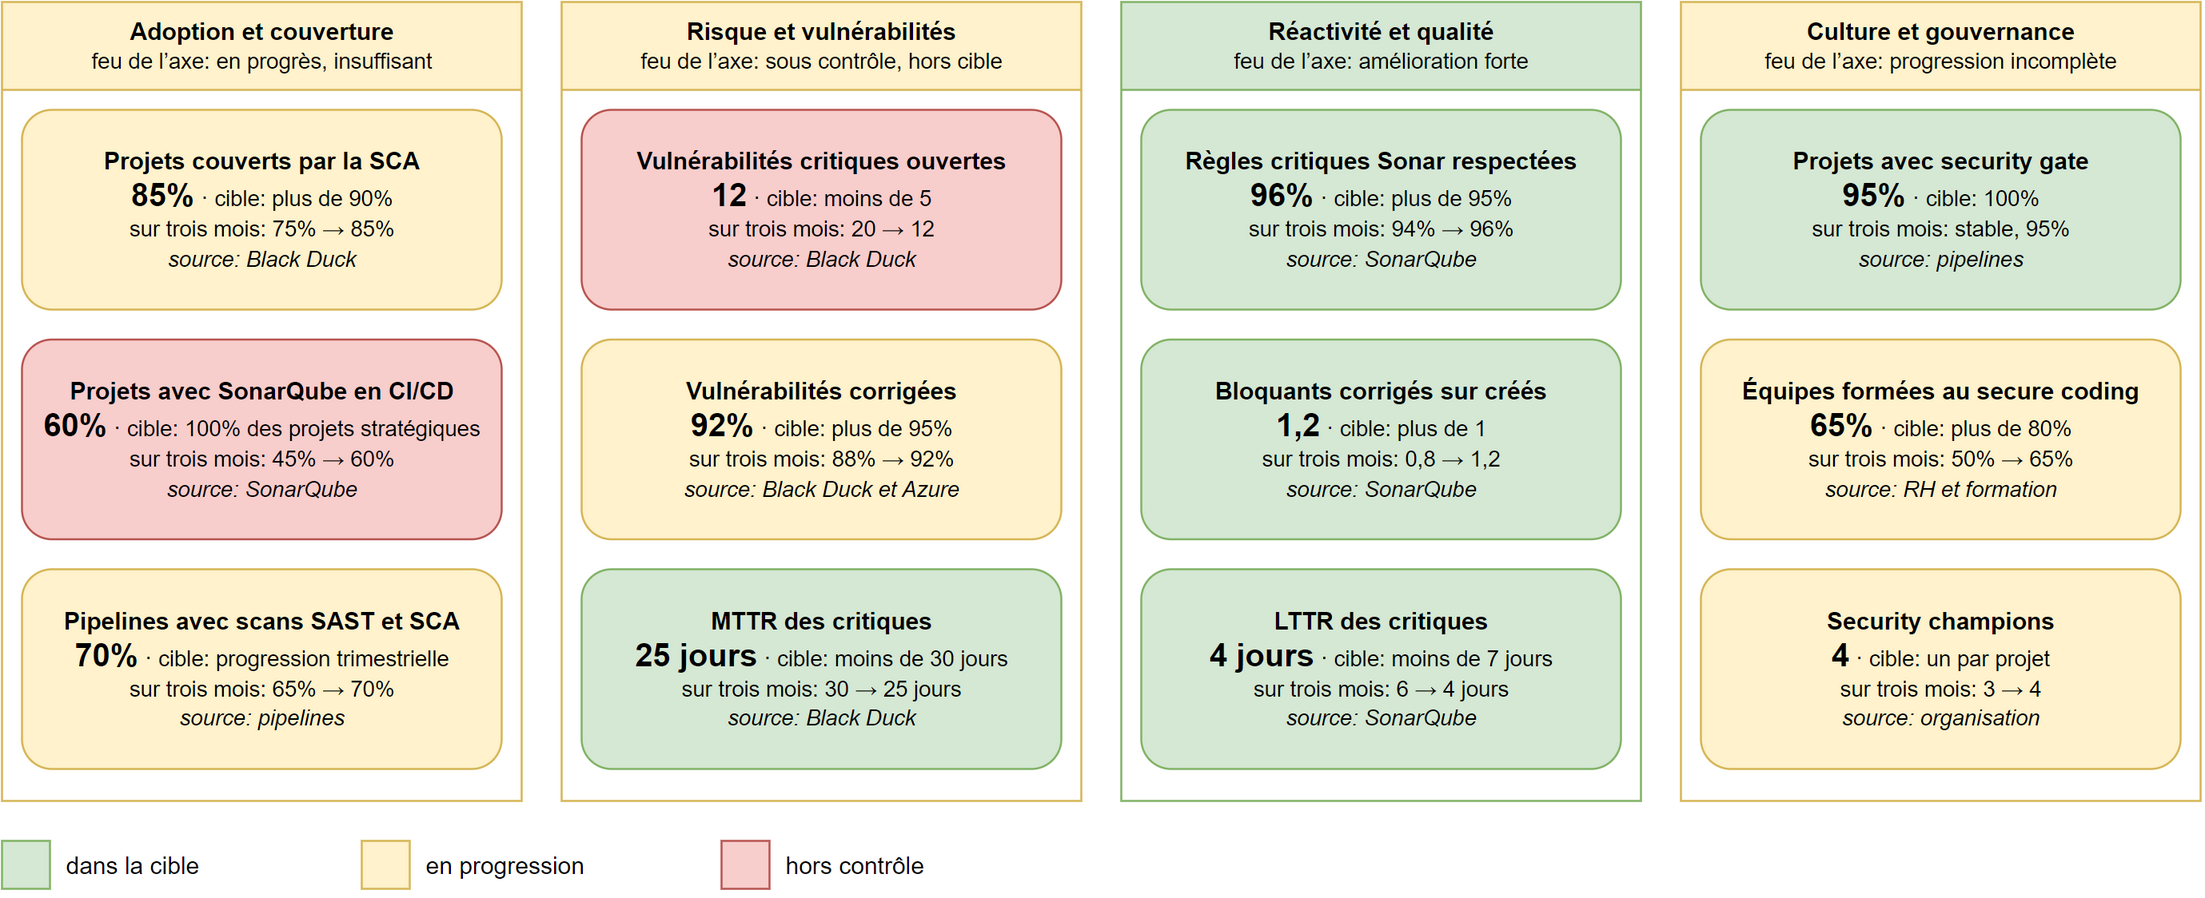
- Adoption et couverture. Les projets couverts par l’analyse de composition logicielle (SCA, ici Black Duck): 85% pour une cible de plus de 90%, contre 75% trois mois plus tôt. Les projets qui ont SonarQube dans leur CI/CD: 60%, contre 45%, pour une cible de 100% des projets stratégiques. Les pipelines avec des scans SAST et SCA: 70%, contre 65%, avec une progression trimestrielle pour cible.
- Risque et vulnérabilités. 12 vulnérabilités critiques ouvertes, contre 20, pour une cible de moins de 5. 92% de vulnérabilités corrigées, contre 88%, pour plus de 95%. Le temps moyen de correction des critiques (MTTR) passe de 30 à 25 jours, sous la cible de 30.
- Réactivité et qualité. 96% des règles critiques de SonarQube respectées, pour plus de 95%. Un ratio de 1,2 entre éléments bloquants corrigés et créés, contre 0,8: l’équipe corrige plus qu’elle ne crée. Un délai de prise en charge et de correction des critiques (LTTR) de 4 jours, contre 6, pour moins de 7.
- Culture et gouvernance. 95% des projets passent un security gate avant la production, un taux stable, pour 100%. 65% des équipes formées au secure coding, contre 50%, pour plus de 80%. 4 security champions, contre 3, pour un par projet.
Ce que le mois apprend
Une tendance plutôt qu’un chiffre. Douze vulnérabilités critiques, c’est rouge: la cible est sous cinq. Mais il y en avait vingt, trois mois plus tôt. Un chiffre seul déclenche une alerte; la tendance dit si l’action en cours suffit. L’intégration de SonarQube est rouge sur le chiffre du mois et jaune en tendance: les deux lectures sont vraies, et il faut les deux.
Pondérer le stock. En mai, le parc cumulait 217 vulnérabilités, une même vulnérabilité comptant dans chaque projet où elle apparaît. Il réunissait quatorze projets et vingt et un dépôts, beaucoup de projets séparant l’API de l’interface. En ne gardant que celles pour lesquelles un exploit est documenté, le stock tombe à 97. C’est un second levier de priorisation, à côté de la criticité donnée par le score CVSS: le score dit la gravité, l’exploit dit l’urgence. Le DSOMM en fait d’ailleurs une activité, l’estimation de la probabilité d’exploitation.
Un stock qui monte n’est pas toujours une mauvaise nouvelle. En juin, le stock cumulé a pris 13%, par la seule évolution des bases de référence, sans aucune correction ce mois-là: la sécurité avait cédé la priorité au reste du développement. En août, il a pris 19%, surtout du fait des dépôts qui entraient dans l’analyse, alors que le nombre de vulnérabilités distinctes baissait de six en un mois. Le stock se lit avec la couverture, jamais seul.
Les dépendances transitives sans correctif. Les corrections portent d’abord sur les dépendances directes. Certaines vulnérabilités des dépendances transitives n’ont pas de correctif accessible, et l’une d’elles, d’après les security champions, demanderait de profondes modifications de l’application. Ce cas repose une question qu’aucun scan ne règle: la liste des composants autorisés, choisie avant d’intégrer une bibliothèque plutôt qu’après.
Les trous de l’outillage se mesurent aussi. En juin, un dépôt a cessé d’apparaître dans les rapports de la SCA; en août, il y revenait avec un autre. Un dépôt qui sort des rapports fait baisser le stock sans qu’une seule faille soit corrigée: c’est l’indicateur de couverture qui le révèle. Côté analyse statique, dont l’outil compte ses projets à sa façon, sur 39 projets notés, 36 ont la note A et 3 échouent sur la sécurité, une note D et deux notes E; les security champions en mènent l’analyse.
Le résumé pour la direction
La première page tient en quatre feux, un par axe: vert dans la cible, jaune en progression, rouge hors contrôle. Sous chaque feu, trois lignes: une tendance, un risque, une action. Les pages suivantes détaillent un axe chacune, en graphique, avec l’écart à la cible, son analyse, le plan d’action et le risque associé.
En août, cette page disait ceci.
- Adoption et couverture, jaune, en progrès mais insuffisant. Tendance: +10 points de couverture Black Duck, +15 pour SonarQube. Risque: des projets restent hors contrôle, avec une exposition qui n’est pas suivie. Action: accélérer l’intégration à SonarQube et rendre la sécurité obligatoire dans tous les pipelines.
- Risque et vulnérabilités, jaune, sous contrôle mais pas dans la cible. Tendance: huit vulnérabilités critiques de moins, un MTTR de 30 à 25 jours. Risque: la cible de moins de cinq n’est pas atteinte. Action: prioriser les critiques restantes, renforcer le suivi des délais de correction.
- Réactivité et qualité, vert, amélioration forte et continue. Tendance: un ratio de 0,8 à 1,2, un LTTR de 6 à 4 jours, 96% de conformité. Risque: un ralentissement si le volume de tickets explose. Action: tenir le rythme de correction, anticiper la capacité si les livraisons augmentent.
- Culture et gouvernance, jaune, progression incomplète. Tendance: +15 points d’équipes formées, un security champion de plus. Risque: des projets inégaux, une dépendance à quelques champions. Action: intensifier les formations, généraliser les champions.
Le feu d’un axe ne peut pas être plus vert que son indicateur le plus rouge. La tendance du risque est bonne, mais les vulnérabilités critiques ouvertes restent au-dessus de la cible: l’axe reste jaune tant que l’écart demeure. Un feu vert à côté d’un indicateur rouge cacherait cet écart à qui ne lit que la première page.
Trois recommandations en découlent: rendre SonarQube obligatoire dans tous les pipelines, établir un plan d’action priorisé sur les douze vulnérabilités critiques restantes, former toutes les équipes et généraliser les security champions.
Une phrase plus longue
Le modèle de maturité et le tableau de bord se répondent. La heatmap dit, preuve par preuve, ce que les équipes savent faire; les indicateurs disent, chaque mois, ce que cela change sur le parc.
«Oui, on scanne» devient: 85% des projets, 90% visés, dix points de plus en trois mois, et deux dépôts qui étaient sortis des rapports, réintégrés. La phrase est plus longue. C’est la seule sur laquelle une direction peut décider.