Sur beaucoup de plateformes internes, obtenir un service ressemble encore à ceci. L’équipe produit remplit un document de demande. Un exploitant de la plateforme le lit, déclenche le pipeline qui fournit le service, puis rend la main. Le modèle a des qualités réelles: un contrôle centralisé des ressources, une équipe produit accompagnée dans chacune de ses demandes. Il a aussi un prix que chacun connaît: des délais en plus, des exploitants occupés à des tâches manuelles, des développeurs sans autonomie, peu de souplesse. Au bout du compte, un goulot d’étranglement.
La cible paraît simple. L’équipe produit complète sa demande dans une interface, et le service est fourni automatiquement. Un intermédiaire humain disparaît du chemin.
J’ai travaillé sur les lignes directrices d’un tel passage au self-service pour une plateforme interne. La conclusion qui en ressort n’est pas technique: l’outillage est la partie facile. Le dernier kilomètre tient à trois questions que l’automatisation ne tranche pas: qui décide, à qui l’on fait confiance, et ce que l’équipe plateforme cesse de faire.
L’escalier de l’effort
Plaçons trois modes de fonctionnement sur deux axes: en abscisse l’effort, en ordonnée l’impact, mesuré en délai de mise sur le marché et en optimisation des ressources. Le fonctionnement legacy est en bas à gauche. La plateforme actuelle, sur ticket, est nettement plus haut, au prix d’une longue montée. Le self-service est plus haut encore, et pourtant à peine plus à droite.
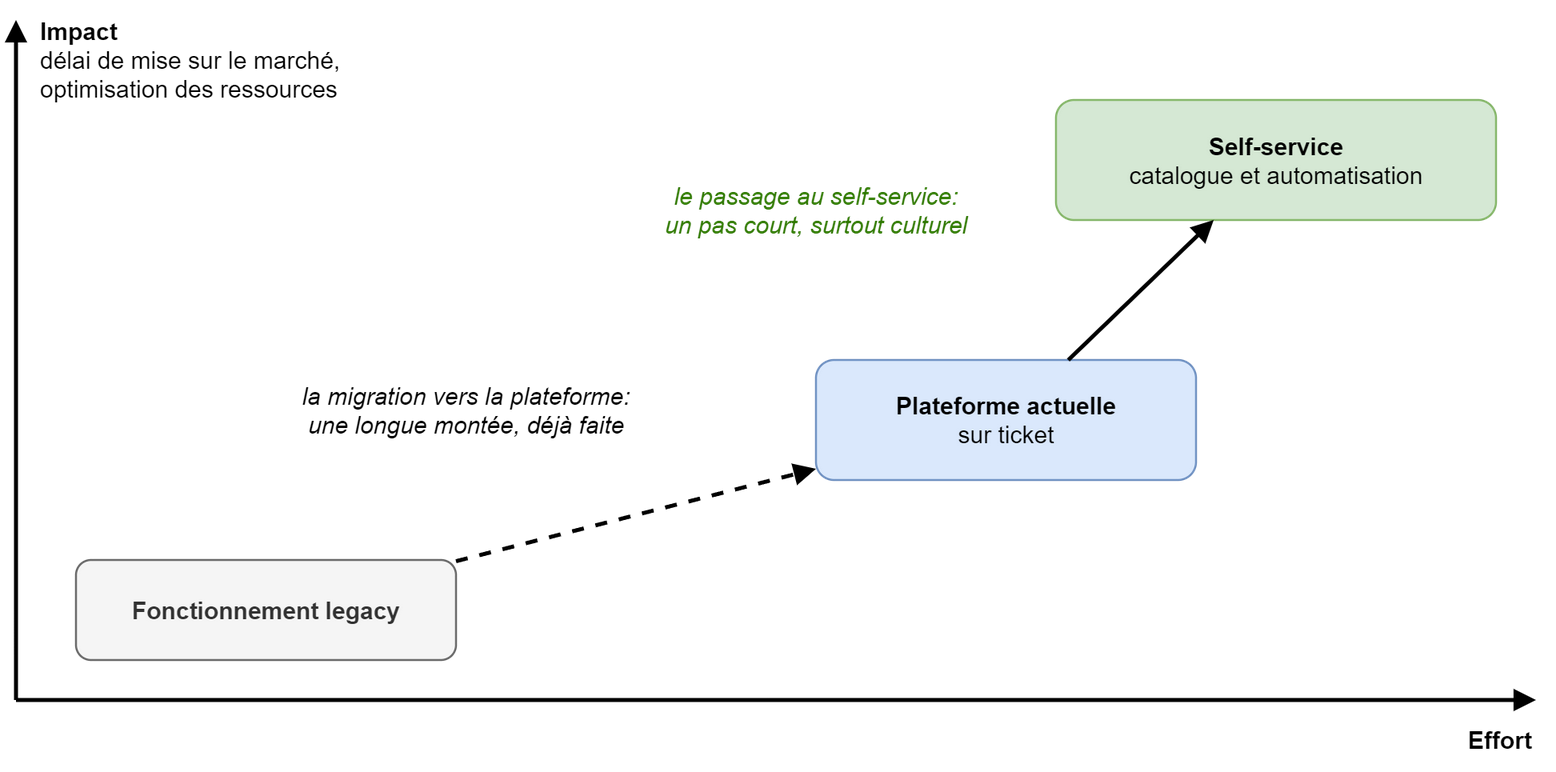
C’est la conclusion centrale de l’analyse: l’effort à fournir pour passer de la plateforme actuelle au self-service est bien moins important que celui déjà consenti pour passer du legacy à la plateforme. Les pipelines existent, les services aussi. Ce qui manque se concentre sur trois sujets.
- Brancher une interface sur les pipelines existants, pour que l’utilisateur souscrive seul au service. Les utilisateurs et les exploitants sont associés aux travaux, pour que l’interface parte du besoin et de l’expérience de celui qui s’en sert.
- Surveiller les usages: des indicateurs et des moyens de contrôler l’usage du service et des ressources associées, des métriques et des alertes affinées par amélioration continue, et un ambassadeur des usages nommé dans chaque projet.
- Former et communiquer, pour que les utilisateurs soient autonomes et responsabilisés dans l’utilisation du catalogue.
Un seul des trois est technique, et même celui-là commence par s’asseoir avec les utilisateurs. L’effort, disent les recommandations, est réparti sur ces trois sujets et concentré principalement sur le changement de culture.
Ce que dit la grille d’impact
Pour mesurer ce que le self-service change chez ceux qui fournissent les services, l’analyse note l’impact sur quatre thèmes, de 1, le plus faible, à 4, le plus fort.
- Métier, niveau 2. L’exploitant disparaît comme intermédiaire des demandes; ce qu’il faut fournir pour chaque demande est standardisé et simplifié.
- Fonctionnement, niveau 2. Les processus et les responsabilités évoluent: gestion des demandes, des incidents, mise à jour du catalogue.
- Outils, niveau 3. Un nouvel outil: une interface qui centralise les offres, accessible aux utilisateurs.
- Culture, niveau 3. De nouvelles valeurs professionnelles: la responsabilisation dans l’utilisation du catalogue.
L’échelle de la culture va du renforcement d’un vocabulaire, au niveau 1, au bouleversement culturel, au niveau 4. Le niveau 3, celui du self-service, s’appelle «nouvelles valeurs professionnelles». Pour les outils, le même niveau 3 signifie le remplacement ou l’ajout d’un ou de quelques outils.
Outils et culture pèsent donc autant. Ils ne sont pourtant pas de même nature. Un outil a une date de livraison: on sait le jour où l’interface est en production. Une valeur n’en a pas. Personne ne peut dire le jour où une équipe est devenue responsable de ses usages. C’est pourquoi les leviers inscrits en face de chaque thème sont toujours les mêmes: formation et documentation, communication, sponsorship. Aucun n’est une automatisation.
Un cas concret: les topics Kafka
Le retour d’expérience joint aux recommandations le montre mieux qu’une grille. Une équipe Kafka centrale gérait le bus d’échange de messages de 150 applications et ses 15 000 topics. Au départ, chaque topic se demandait par un ticket Jira. À mesure que l’intégration réactive avec Kafka gagnait les applications, les demandes de création augmentaient, jusqu’à devenir ingérables pour une équipe de 5 ETP, qui devait aussi maintenir Kafka lui-même: mises à jour, administration, supervision. Les équipes de développement attendaient.
Deux activités pénalisaient le flux: la création et la modification des topics. La suppression, épisodique, est restée manuelle.
La réponse tient en trois éléments. Un projet Git dédié à la gestion des topics, où chaque projet ou application possède son propre fichier de configuration au format YAML. Chaque équipe met à jour son fichier quand elle en a besoin. Un pipeline se déclenche à chaque mise à jour et valide la configuration selon des critères prédéfinis; si elle est valide, il l’applique sur les environnements hors production. Pour la production, l’équipe Kafka centrale doit créer un tag.
Le format exact n’est pas l’enjeu. Un fichier d’équipe peut ressembler à ceci, avec des noms inventés et les réglages de topic que Kafka expose:
# Exemple simplifié
application: facturation
topics:
  - name: facturation.factures-emises
    partitions: 6
    replicationFactor: 3
    config:
      retention.ms: 604800000
      cleanup.policy: delete
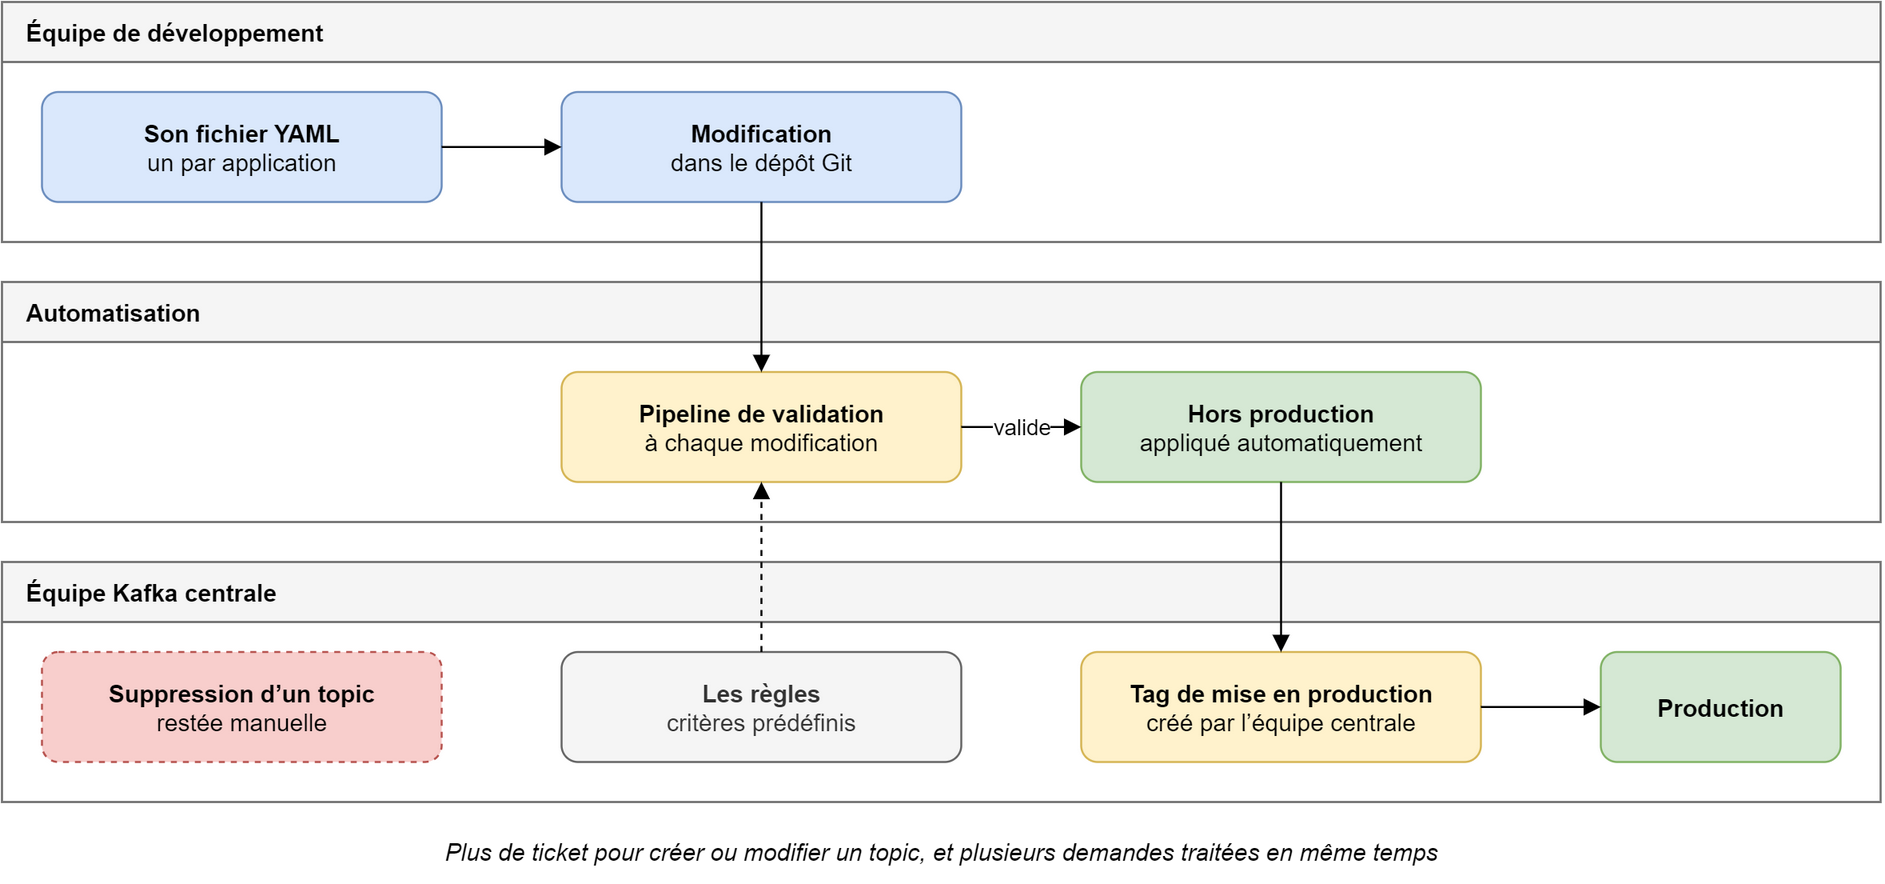
Le retour d’expérience décrit trois effets. Les tickets liés à la gestion des topics ont disparu, sauf pour la suppression. Les équipes de développement sont devenues totalement autonomes. Et plusieurs demandes sont traitées en même temps, là où les tickets l’étaient l’un après l’autre.
Le retour d’expérience s’arrête là. Il ne donne aucun chiffre de délai, ni avant ni après, et je n’en inventerai pas. Ce qui est établi suffit: la file a disparu, et avec elle l’ordre d’arrivée qui faisait attendre chaque équipe derrière les autres.
Où se place la confiance
Regardons ce que l’équipe centrale a gardé. Pas l’exécution: elle est partie dans le pipeline. Elle a gardé deux décisions. Les règles, écrites une fois et appliquées à chaque modification. Et le tag, là où elle décide encore, à chaque fois, de ce qui atteint la production. Elle a gardé enfin un geste, la suppression, faite à la main. Épisodique, dit le retour d’expérience. C’est aussi l’opération qu’on ne rattrape pas: un topic supprimé emporte ses messages.
Voilà la vraie conception d’un self-service. Ce n’est pas «tout automatiser», c’est décider où se place la confiance. Hors production, elle est donnée à l’équipe, encadrée par des règles. En production, elle est partagée: l’équipe propose, l’équipe centrale pose le tag. Le dépôt Git, les fichiers YAML et le pipeline ne font qu’inscrire cette décision dans l’outil. Si personne ne la prend, l’outillage reproduit le ticket sous une autre forme: une demande de fusion qui attend la même personne que le ticket attendait.
La confiance, ensuite, se gagne. Les recommandations proposent un système de badges, obtenus après le parcours de formation associé à chaque service: seuls les utilisateurs formés peuvent souscrire aux offres correspondantes. Elles demandent un ambassadeur des usages par projet, et des métriques et des alertes contre les mauvais usages. Le self-service a deux inconvénients: il faut former les équipes produit, et les ressources risquent d’être mal utilisées. Ils se traitent ainsi, dans le plan de conduite du changement et dans la définition des rôles, plutôt qu’en verrouillant l’interface.
Ce que l’équipe plateforme cesse de faire
La grille d’impact le dit en une ligne: l’intermédiaire disparaît. L’équipe plateforme cesse d’exécuter les demandes. C’est la partie la plus difficile à annoncer, parce qu’elle touche au rôle des personnes, pas à leurs outils.
Ce qu’elle fait à la place est plus exigeant. Chaque fournisseur de service définit et maintient les critères d’éligibilité et les conditions d’utilisation de son service, gère son cycle de vie, contribue aux pipelines d’automatisation, teste et donne les moyens de tester. Il maintient ses services en condition opérationnelle, pilote leurs indicateurs et la dette des services hébergés, forme et accompagne les utilisateurs, organise le support. Le catalogue devient un produit: une vision et un backlog, une structure et un vocabulaire cohérents, une charte d’intégration, une équipe qui valide l’éligibilité et fait vivre la communication.
L’utilisateur reçoit sa part. Il utilise le catalogue en respectant les conditions d’utilisation, fait des retours réguliers aux fournisseurs, propose des évolutions des offres. Il construit et exploite son produit, et gère sa dette technique en suivant les évolutions du catalogue. Le self-service ne retire pas la responsabilité, il la déplace.
Deux recommandations en découlent. Distinguer les vrais services fournis des ressources documentaires et des kits: une page de documentation n’est pas un service. Et confier chaque type de service à une équipe d’exploitation qui en répond, plutôt qu’à tout le monde à la fois.
Commencer par le service le plus demandé
Le catalogue se construit progressivement, en commençant par les services les plus critiques ou les plus demandés. Les topics Kafka en sont l’exemple même: c’est la file la plus longue qui a justifié l’automatisation. Chaque offre est validée avec une application pilote avant de rejoindre le catalogue, puis ajustée au fil des retours. Un processus clair, avec des critères d’approbation explicites, encadre l’ajout, la modification et le retrait d’un service. Et un expert, en immersion dans les équipes, accélère et guide les travaux mieux qu’une documentation envoyée de loin.
Le dernier kilomètre
Un dépôt Git, des fichiers YAML, un pipeline qui valide: rien de tout cela n’est difficile en 2024. Le dernier kilomètre est ailleurs. Écrire les règles plutôt que traiter les demandes. Choisir où l’équipe centrale garde la main, et pourquoi. Former avant d’ouvrir. Laisser chaque équipe porter son fichier, et accepter qu’elle en réponde.
Une plateforme qui automatise sans trancher ces questions ne supprime pas la file d’attente. Elle la déplace.