Une équipe qui trouve sa chaîne de livraison lente demande presque toujours la même chose: des pipelines plus rapides. Des agents de build plus puissants, des tests parallélisés, une analyse de sécurité allégée. C’est une réponse raisonnable à une question mal posée.
Ces dernières semaines, j’ai cartographié une chaîne CI/CD complète, du changement de code jusqu’au déploiement sur chaque environnement. Le pipeline d’intégration traitait un changement en 14 minutes. Le déploiement d’une version sur un environnement prenait 802 minutes, dont 70 de travail effectif. Pendant les 732 autres, personne ne travaillait: le changement attendait.
Ce qu’une cartographie mesure
La cartographie de la chaîne de valeur, le value stream mapping, vient du lean industriel; Mike Rother et John Shook l’ont décrite en 1999 dans Learning to See. Elle repose sur trois mesures, et elle s’applique telle quelle à une chaîne logicielle.
- Les étapes. On suit un changement de bout en bout, de la modification du code à la création des artefacts, puis au déploiement des composants sur les différents environnements, et l’on note chaque activité, qu’un humain ou une machine la réalise.
- Le temps de traitement. Pour chaque étape, le temps pendant lequel quelqu’un ou quelque chose travaille réellement sur le changement: une compilation, une analyse, une saisie dans un formulaire.
- Le temps d’attente. Entre deux étapes, le temps pendant lequel le changement est prêt et où rien ne se passe: un déclencheur qui n’est pas encore passé, un ticket dans une file, un courriel non lu.
Le délai de bout en bout, le lead time, est la somme des deux. Les mesures sont des moyennes, exprimées en minutes, et chaque étape porte deux marques de plus: son déclenchement, manuel ou automatique, et sa répétition éventuelle sur chaque environnement.
On dessine d’abord l’état actuel, tel qu’il est et non tel que la documentation le décrit, puis un état cible, avec les mêmes mesures. La comparaison des deux dit où se trouve le gain. Et le rapport entre le temps de traitement et le délai total, que l’on appelle souvent l’efficacité du flux, dit à lui seul où chercher.
La CI: trois déclencheurs, un même pipeline
L’intégration continue de cette chaîne pouvait démarrer de quatre façons. Le polling: Jenkins interrogeait le dépôt toutes les 20 minutes et lançait le pipeline s’il trouvait une modification. Le nightly: un lancement chaque nuit sur toutes les branches. Le webhook: GitLab déclenchait le pipeline à chaque push. Et un lancement manuel, depuis l’interface de Jenkins, pour produire une version.
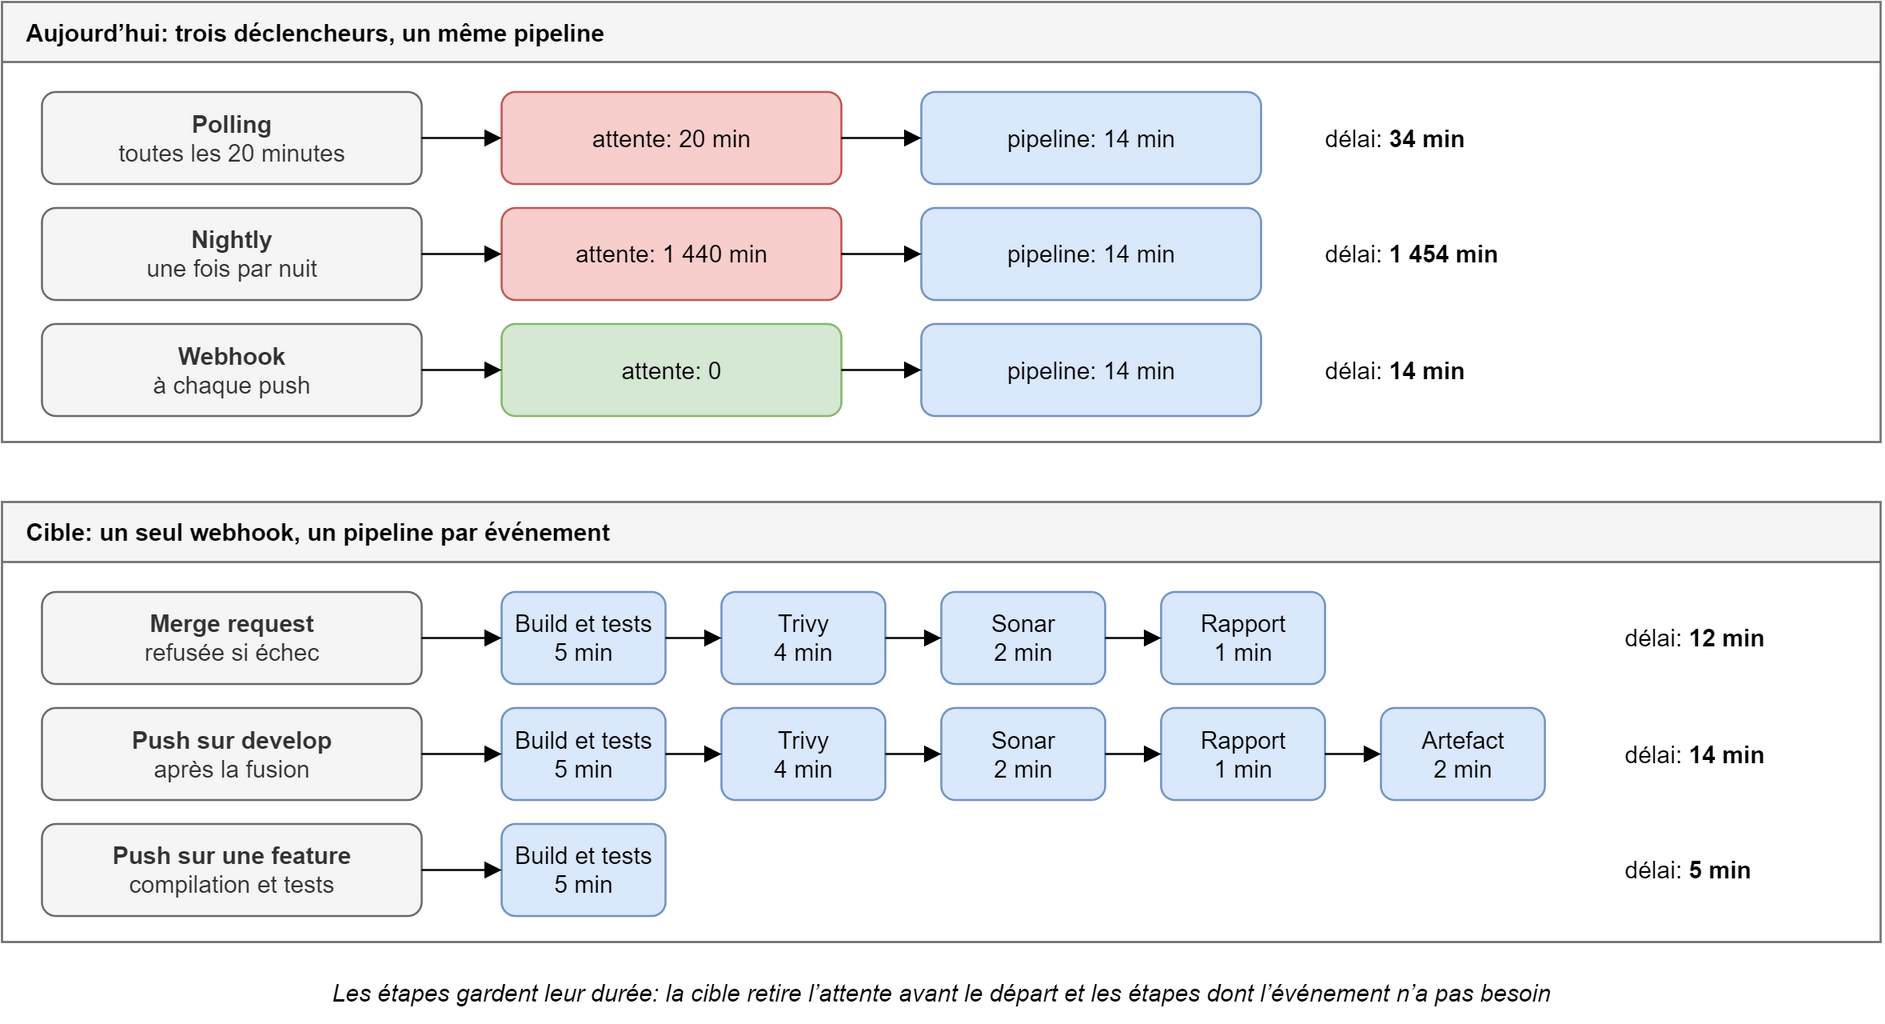
Les trois premiers exécutaient le même pipeline: compilation et tests, analyse de sécurité avec Trivy, qualimétrie avec SonarQube, rapport par courriel. La cartographie leur donnait trois délais: 34 minutes pour le polling, 1 454 pour le nightly, 14 pour le webhook. La différence ne tenait à aucune étape; le traitement durait 14 minutes dans les trois cas. Elle tenait à l’attente avant la première étape: 20 minutes pour le polling, 1 440 pour le nightly, aucune pour le webhook. Le nightly, c’est une file d’attente de vingt-quatre heures devant un traitement de quatorze minutes: moins de 1% de son délai est du travail.
L’attente a un effet que la carte ne chiffre pas, mais qu’elle explique. Les développeurs, lassés d’attendre le prochain passage du polling, lançaient souvent le pipeline à la main. Un déclencheur lent ne ralentit pas seulement la chaîne, il pousse l’équipe à la contourner. La recommandation était sans détour: le polling est un mode inutile, le webhook doit être le seul.
La cible CI: un webhook, un pipeline par événement
La cible garde un seul déclencheur, le webhook GitLab, et distingue les événements qu’il transmet grâce au plugin GitLab de Jenkins, qui sait filtrer par événement et par branche.
- Une merge request lance la compilation, les tests et les analyses; si le pipeline échoue, la fusion est refusée. Délai: 12 minutes.
- Un push sur develop, une fois la merge request acceptée, refait le même parcours et crée dans Nexus un artefact snapshot identifié par le sha1 court du commit. Délai: 14 minutes.
- Un push sur une branche de feature se limite à la compilation et aux tests. Délai: 5 minutes.
- Un tag publie une version dans Nexus.
Les sommes se vérifient étape par étape. Cinq minutes de compilation et de tests, 4 minutes d’analyse de sécurité, 2 de qualimétrie et 1 de rapport font 12; la création de l’artefact en ajoute 2 et donne 14; la compilation et les tests seuls font 5. Aucune de ces étapes n’est plus rapide qu’avant. La cible ne gagne rien sur le traitement: elle supprime l’attente devant le pipeline et retire, pour chaque événement, les étapes dont il n’a pas besoin. Le lancement manuel reste possible, sans polling ni nightly pour le compenser.
Elle a un coût, que la carte oblige à écrire: retravailler le pipeline pour qu’il distingue les événements, et confier aux développeurs la configuration de GitLab et du webhook.
La CD: 802 minutes, dont 732 minutes d’attente
La chaîne de déploiement comptait six activités, toutes déclenchées à la main, et répétées sur chaque environnement jusqu’à la production.
- La livraison: le développeur saisit les données de livraison dans un outil, qui prévient par courriel l’équipe de qualification. 10 minutes.
- La vérification: après une demande d’installation, l’exploitation contrôle et valide la configuration dans un référentiel, et met à jour les inventaires. 10 minutes.
- La validation de la livraison, avec la copie de l’artefact dans un second dépôt Nexus. 5 minutes.
- La valorisation: les valeurs des inventaires sont renseignées dans GitLab, puis la version est taguée. 30 minutes.
- Le pré-déploiement: un job Jenkins en mode dry-run, avec initialisation, plan de déploiement, configuration et déploiement à blanc. 5 minutes.
- Le déploiement en mode réel, où une désactivation puis une réactivation sur le répartiteur de charge encadrent le plan de déploiement et la configuration. 10 minutes.
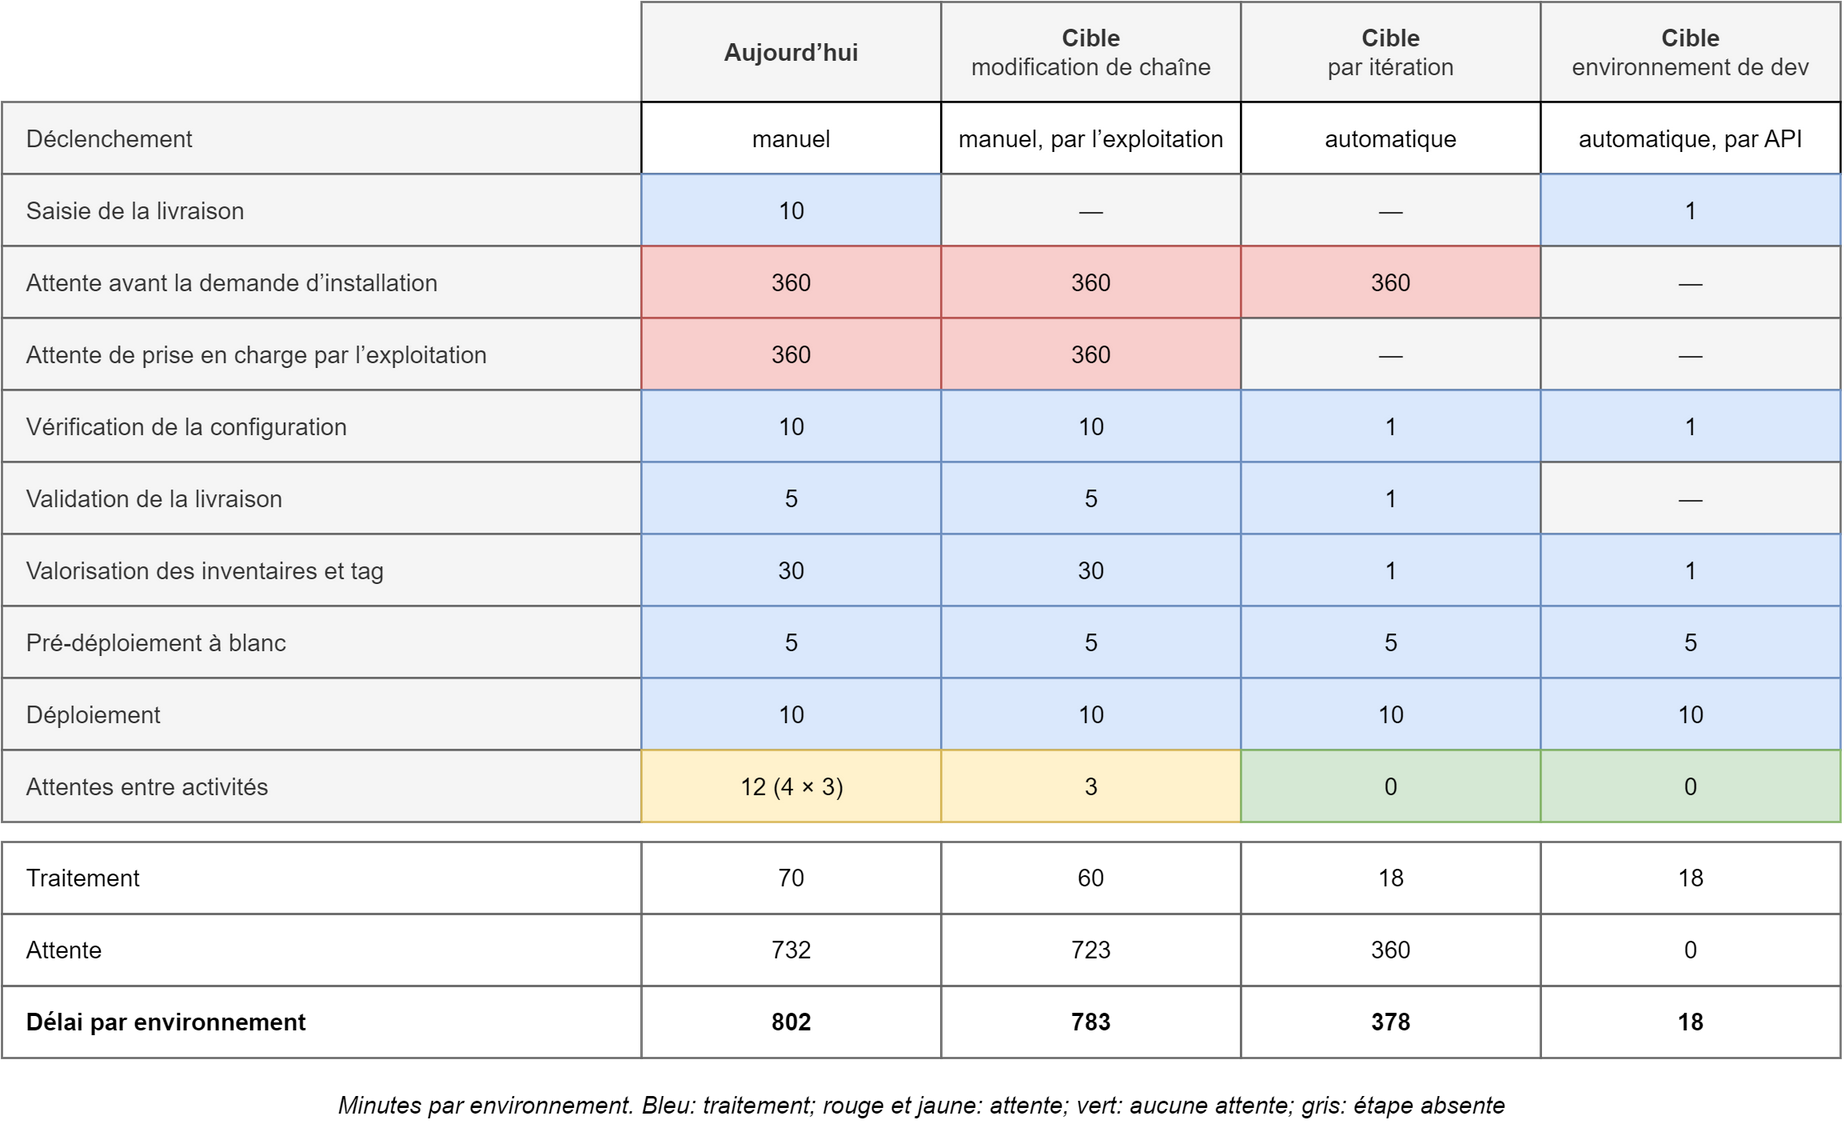
Le traitement total fait 70 minutes. Entre la livraison et la vérification se trouvent deux files de 360 minutes chacune: celle de l’équipe de qualification, qui dépose la demande d’installation, et celle de l’exploitation, qui la prend en charge. S’y ajoutent 3 minutes d’attente à chacune des quatre transitions suivantes. L’attente totale fait 732 minutes, et chaque exécution prend 802 minutes par environnement: plus de treize heures, de quoi n’en tenir que trois par semaine. Plus de 91% du délai est de l’attente.
Pourquoi l’attente domine
Chaque passage de relais entre deux personnes ou deux équipes transite par une file: un courriel, un ticket, une demande dans un outil. La durée d’une file ne dépend pas du travail à faire; elle dépend de la disponibilité de celui qui la vide. Six heures d’attente devant une vérification de dix minutes ne disent rien de la vérification. Elles disent qu’elle n’est la priorité de personne au moment où elle arrive.
La conséquence se lit dans les chiffres. Diviser par deux la durée du déploiement réel ferait gagner 5 minutes sur 802. Supprimer une seule des deux files en fait gagner 360. Une équipe qui optimise ses scripts travaille sur moins d’un dixième du délai.
C’est aussi pour cela que l’attente reste invisible. Chaque activité, prise isolément, est rapide et bien faite; chaque équipe peut montrer que sa part prend dix minutes. Les files sont entre les équipes, et ce qui est entre les équipes n’appartient à aucune. Le premier objectif fixé à cette cartographie était justement de supprimer la rupture entre les différentes chaînes, et de proposer une chaîne au même périmètre pour les équipes de développement et pour l’exploitation. C’est une question d’organisation avant d’être une question d’outillage. La carte doit donc être lue par ceux qui décident de l’organisation, pas seulement par ceux qui écrivent les pipelines.
Ce que la cible retire
La cible de la CD ne tient pas en un chiffre: elle en donne trois, selon la nature du changement.
- Sur l’environnement de développement, une API déclenche toute la chaîne. La livraison, la vérification et la valorisation prennent une minute chacune, le pré-déploiement 5, le déploiement 10, sans attente entre elles. Délai: 18 minutes.
- Sur les environnements gérés par l’exploitation, pour une modification de chaîne, un ajout de paramètres ou de composants, l’intervention d’un exploitant reste nécessaire. Les deux files de 360 minutes demeurent, avec une attente de 3 minutes; la saisie manuelle de la livraison disparaît, et trois des quatre petites attentes avec elle. Traitement 60, attente 723, délai 783 minutes: 19 minutes gagnées, pas davantage.
- Pour une itération, une simple montée de version, le référentiel de configuration déclenche seul le reste de la chaîne. Il ne reste qu’une file de 360 minutes, devant la demande d’installation; la vérification, la validation et la valorisation prennent une minute chacune dans le pipeline de déploiement. Traitement 18, attente 360, délai 378 minutes.
Entre 802 et 378 minutes, le traitement a baissé de 52 minutes, l’attente de 372. Le gain est dans les files. Et les 378 minutes qui restent sont encore de l’attente à plus de 95%: la file devant la demande d’installation, que l’automatisation n’a pas touchée parce qu’elle n’est pas un problème d’automatisation.
La cible choisit aussi ce qu’elle laisse manuel. La validation de la livraison reste en l’état pour une modification de chaîne, parce que l’automatiser demandait une modification conséquente de l’outil qui la porte. Le déploiement automatique, déclenché quand le dry-run réussit, s’arrête avant la production. Et la séparation des environnements, chacun avec son propre déclenchement, permet d’automatiser l’un sans toucher aux autres: une modification agit localement, sans conséquence transverse.
Mesurer avant d’accélérer
La question utile n’est pas «comment rendre nos pipelines plus rapides?». Elle est «où le changement attend-il, et pendant combien de temps?». On n’y répond pas en lisant les journaux du serveur d’intégration, qui ne voient que le traitement. On y répond en suivant un changement de bout en bout, minute par minute, entre les étapes autant que dedans.
Le résultat déplace la discussion. Sur cette chaîne, les quatorze minutes du pipeline n’étaient le problème de personne. Les deux files de six heures étaient le problème de tout le monde, et donc de personne non plus, jusqu’à ce qu’une carte les mette sous les yeux de ceux qui pouvaient les supprimer.